語音活動與音高
拿到一段語音錄音,我幾乎做任何事之前都會先問兩個問題:裡面哪裡有人在說話,以及說話的人音高多少。vad(語音活動偵測)和它的相關函式回答第一個問題,除了 numpy 之外什麼都不需要。f0 回答第二個:它用 librosa 的 pYIN(機率式 YIN)追蹤基頻,並把有聲/無聲的判斷和音高放在一起。
| 要做的事 | 用 |
|---|---|
找出哪裡有人在說話,以秒為單位的 (start, end) 表示 |
vad |
| 把每一段語音各切成一個片段 | vad_split |
| 丟掉第一個字之前和最後一個字之後的所有東西 | vad_trim |
| 找出資料夾裡沒有語音的錄音 | speech_ratio |
| 把每個頻譜圖音框標成語音或非語音 | vad_frames |
| 追蹤音高,以及哪裡有音高 | f0,回傳 PitchTrack |
| 在編輯器裡打開任一個結果 | Label、save_labels |
下面每個範例都跑在同一段合成錄音上。請在空資料夾裡把框裡的程式碼執行一次。後面的程式碼區塊都接著它繼續,numpy 和 kudio 已經匯入,三個檔案也都已經就位,印出來的就是頁面上顯示的結果。
本頁使用的錄音
三個音高滑動的有聲字詞,一個 /s/ 緊接著帶進第二個字,還有一陣不是語音的大聲寬頻碰撞聲。quiet.wav 把它們放在安靜的房間裡,fan.wav 放在一台風扇前面,empty.wav 則只有碰撞聲和風扇,沒有人說話。
import numpy as np
import kudio

sr = 16000
n = 6 * sr
rng = np.random.default_rng(7)

def at(start, x):                      # place x at `start` seconds
    out = np.zeros(n)
    out[int(start * sr):int(start * sr) + len(x)] = x
    return out

def vowel(seconds, f_from, f_to, level=1.0):   # harmonics of a gliding f0
    m = int(seconds * sr)
    phase = 2 * np.pi * np.cumsum(np.linspace(f_from, f_to, m)) / sr
    tone = sum(np.sin(k * phase) / k for k in range(1, 16))
    return 0.08 * level * tone * np.sin(np.pi * np.arange(m) / m) ** 0.5

def hiss(seconds, level, cutoff=None):         # a noise burst
    m = int(seconds * sr)
    x = rng.standard_normal(m)
    if cutoff:
        x = kudio.highpass(x, sr, cutoff=cutoff)
    return level * x * np.hanning(m)

voice = (at(0.8, vowel(0.8, 140, 110))
         + at(3.0, hiss(0.15, 0.05, cutoff=3500))      # an /s/ ...
         + at(3.12, vowel(0.85, 120, 165))             # ... running into a vowel
         + at(4.6, vowel(0.8, 130, 100, level=0.5)))   # a quieter last word
clatter = at(2.2, hiss(0.25, 0.25))                    # loud, broadband, not speech
room = 0.0005 * rng.standard_normal(n)                 # a quiet room
fan = 0.03 * kudio.lowpass(rng.standard_normal(n), sr, cutoff=1000)

kudio.save_wave("quiet.wav", voice + clatter + room, sr)
kudio.save_wave("fan.wav", voice + clatter + fan, sr)
kudio.save_wave("empty.wav", clatter + fan, sr)       # nobody talking
為什麼光靠靜音門檻不夠
split_on_silence 和 trim_silence(見編輯與效果)只看準位來判斷:一個音框比檔案裡最大聲的音框低超過 top_db(預設 30 dB),就算靜音。下面是同一個人聲在兩個房間裡的情況:
for name in ("quiet.wav", "fan.wav"):
    y, sr = kudio.file_load(name)
    for top_db in (30, 25, 20):
        parts = kudio.split_on_silence(y, top_db=top_db)
        print(f"{name:9}  top_db={top_db}  ", [round(len(p) / sr, 2) for p in parts])
quiet.wav  top_db=30   [0.9, 0.32, 1.02, 0.83]
quiet.wav  top_db=25   [0.83, 0.32, 0.99, 0.77]
quiet.wav  top_db=20   [0.77, 0.29, 0.93, 0.61]
fan.wav    top_db=30   [6.0]
fan.wav    top_db=25   [0.9, 0.32, 1.02, 0.83]
fan.wav    top_db=20   [0.8, 0.29, 0.96, 0.64]
在安靜的房間裡,預設值找到四段。在風扇前面只找到一段,長六秒:就是整個檔案。風扇比最大聲的音框低大約 26 dB,所以在 top_db=30 時它算是聲音。top_db=25 剛好救得了這個檔案,但正確的數字取決於這台風扇和這段錄音最大聲的時刻相比有多大聲,而那個時刻是碰撞聲,不是人聲。為了保險再往下調,就會吃掉字詞:設成 20 時,小聲的最後一個字在風扇聲中從 0.83 秒縮到 0.64 秒,在安靜的房間裡則縮到 0.61 秒。而且只要檔案切成了好幾段,第二段都是碰撞聲,因為 split_on_silence 只問夠不夠大聲。
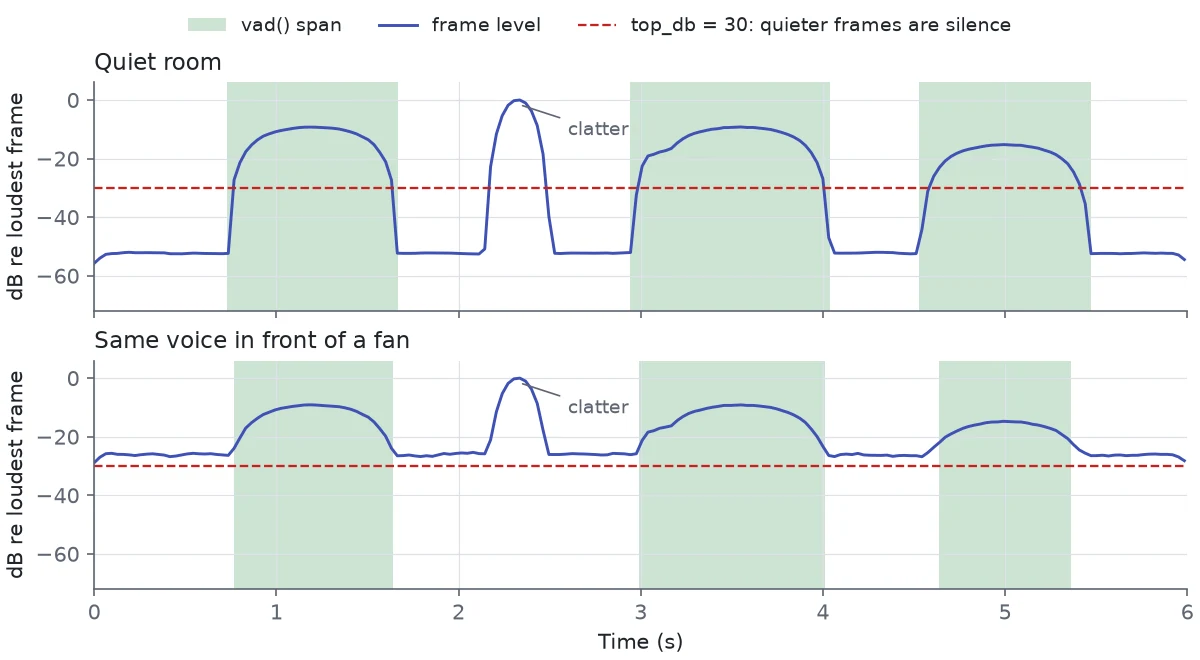
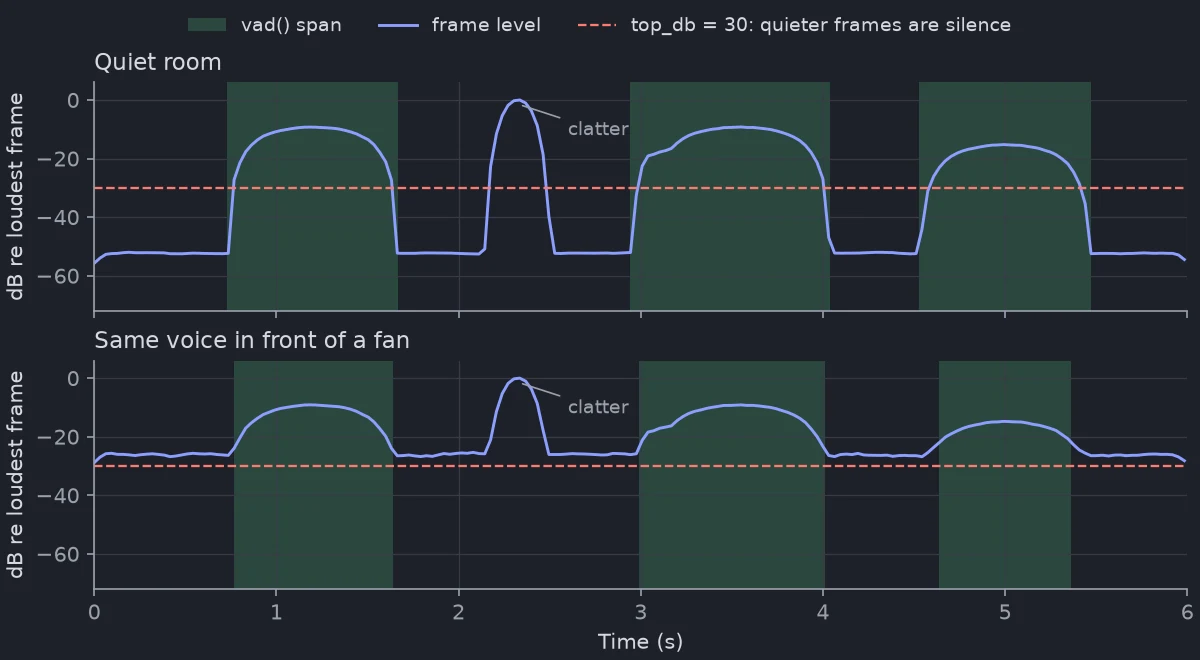
這就是 split_on_silence 量的準位,每個音框都和最大聲的那個比。有風扇聲的那個檔案,沒有任何音框掉到 top_db 虛線以下。陰影區段是 vad 找到的結果,兩個房間用的是同樣的設定:
for name in ("quiet.wav", "fan.wav"):
    y, sr = kudio.file_load(name)
    print(f"{name:9}", [(round(a, 2), round(b, 2)) for a, b in kudio.vad(y, sr)])
quiet.wav [(0.73, 1.67), (2.94, 4.04), (4.53, 5.47)]
fan.wav   [(0.77, 1.64), (2.99, 4.01), (4.64, 5.36)]
每個房間都是三段,沒有碰撞聲,兩次執行之間什麼都沒調。結果是以秒為單位的 (start, end) 配對,沒有任何東西像語音時則是空清單。在風扇聲中,最後一個字變短了,是 4.64 到 5.36 秒,對照安靜房間的 4.53 到 5.47 秒:它的起音和衰減太接近風扇的準位,過不了下面說明的 8 dB 檢驗。threshold_db=6 會把它拉回 4.61 到 5.40 秒,而且沒有多出新的區段;設成 5 時,碰撞聲也會回來,在 2.17 到 2.50 秒。
要處理安靜房間裡不是語音的聲音,例如敲擊聲,split_on_silence 仍然是對的工具。語音則請用 vad。
切割、裁切與計算比例
vad_split 把各區段以波形回傳,vad_trim 保留從第一段語音到最後一段語音之間的所有內容,speech_ratio 則告訴你片段裡有多少是語音。三者都接受和 vad 相同的關鍵字參數。
y, sr = kudio.file_load("fan.wav")

for n, part in enumerate(kudio.vad_split(y, sr), 1):
    kudio.save_wave(f"spans/fan_{n:03d}.wav", part, sr)

clip, (start, end) = kudio.vad_trim(y, sr)
print(start, end, round(len(clip) / sr, 2))
vad_trim 回傳以樣本為單位的 (clip, (start, end)),形式和 trim_silence 一樣,所以使用結果的程式碼兩者都能接。找不到語音時,它會原封不動地回傳片段和完整範圍,empty.wav 就是 (0, 96000),並以 INFO 等級記錄這件事。面對「什麼都沒找到」,把音訊刪掉從來都不是比較安全的解讀。
一資料夾的錄音在變成訓練資料之前,我會先用 speech_ratio 檢查一遍:
from pathlib import Path

for path in sorted(Path(".").glob("*.wav")):
    y, sr = kudio.file_load(path)
    print(f"{path.name:10} {kudio.speech_ratio(y, sr):4.0%}")
empty.wav 裡的碰撞聲比另外兩個檔案裡的任何一個字都大聲,讀數仍然是 0%。在應該都是語音的資料夾裡,一整段接近零的錄音,錄到的是一個房間,不該被當成乾淨目標進到含雜訊資料集裡。
它需要檔案裡有一些背景可以拿來比較。vad 的雜訊底取自檔案本身,所以在從頭到尾都是語音的片段裡,雜訊底就是語音:上面 vad_split 寫出的三個檔案,讀數是 0%、35% 和 0%。請對完整的錄音執行,不要對已經切到只剩字詞的片段執行。
在 shell 裡,kudio vad fan.wav --split-to spans/ 會印出同樣的區段,把每段各寫成一個檔案,沒有語音時以 1 結束;見命令列。
每個頻譜圖音框一個判斷
用頻譜圖音框訓練的模型(見 STFT 與特徵),或是從沒人說話的音框取得的雜訊估計(見降噪),需要的是每個音框的判斷,而不是每個區段的判斷。vad_frames 為每個 STFT 音框給一個布林值,音框中心落在區段裡時為 True:
y, sr = kudio.file_load("fan.wav")
spec = kudio.waveform_to_spectrogram(y)        # (frames, bins), hop 256
speech = kudio.vad_frames(y, sr)               # (frames,), the same frames
print(spec.shape, speech.shape, speech.sum())

background = np.median(spec[~speech], axis=0)  # per bin, over what vad turned down
在預設設定下,它給出的音框和 waveform_to_spectrogram 及 STFT 在各自預設設定下的音框相同。如果你在那邊改了 hop_length、n_fft 或 center,這裡也要傳同樣的值。
不是語音,不等於就是背景。~speech 是被 vad 否決的所有音框,在 fan.wav 裡也包括碰撞聲:232 個音框裡有 18 個和它重疊。把這 18 個排除,在風扇很弱的 2 kHz 以上,對音框取的平均值會變動 3.5 到 4.6 dB,中位數則最多只變動 1.1 dB,這就是範例取中位數的原因。
vad 如何判斷
vad 每 10 ms 看一個 30 ms 的音框(FRAME)。音框首先必須以這個檔案的標準來說夠大聲:雜訊底是音框準位的第 15 百分位數,音框必須比它高出 THRESHOLD_DB(8 dB)。一台從頭轉到尾的風扇,就是那個雜訊底,所以 fan.wav 什麼都不用改。比最大聲的音框低超過 FLOOR_REL_DB(45 dB)的,一律不算語音,所以幾乎無聲的檔案,不會把它自己的嘶聲抬升成語音。
夠大聲的音框接著必須看起來像人聲。頻譜平坦度,也就是音框功率譜的幾何平均除以算術平均,這裡的母音都在 0.001 以下。白雜訊的教科書值是 1.0,但單一個 30 ms 的白雜訊音框量起來是 0.46 到 0.66,平均 0.56,碰撞聲則是 0.53 到 0.61。低於 FLATNESS_MAX(0.40)時,大聲的音框本身就算數,碰撞聲就是在這項檢驗上沒過。
沒通過的大聲音框,如果過零率高於 ZCR_MIN(0.25:相鄰樣本有四分之一會變號,就像 16 kHz 下的 2 kHz 正弦波),而且 FRICATIVE_REACH(0.2 秒)以內有通過的音框,仍然算數。過零率分不出寬頻的摩擦音和一陣嘶聲;旁邊是不是母音才分得出來。這段錄音裡的 /s/ 用不到這條規則:它的頻寬有限,平坦度是 0.045,自己就能通過。
最後,不超過 min_silence 的間隙會被接起來,因為塞音在字裡面本來就是真正的靜音;短於 min_speech 的區段會被丟掉,兩端再各加上 pad。
| 參數 | 預設 | 何時要改 |
|---|---|---|
threshold_db |
8.0 dB | 小聲的說話者被漏掉(調低),或吵雜的房間漏進來(調高) |
flatness_max |
0.40 | 音訊不是語音(1.0 會關掉這項檢驗) |
min_speech |
0.10 秒 | 喀聲和敲擊聲以短區段的形式跑進來(調高) |
min_silence |
0.15 秒 | 字詞在塞音處被切開(調高),或分開的語句被合在一起(調低) |
pad |
0.05 秒 | 切點削掉了第一個或最後一個子音(調高) |
白雜訊就落在預設平坦度上限的上方不遠處,所以調高時要小心:在 quiet.wav 上,0.5 仍然只找到那三個字,0.6 就會讓碰撞聲回來,在 2.14 到 2.51 秒。所有參數都在 API 參考裡。vad 遇到多聲道陣列會引發 FeatureError;file_load 會混成單聲道,除非你傳 mono=False。
會出錯的地方
我用類似上面那段錄音的合成音訊試過,下面這些情況,最好在語料庫替你踩到之前先知道。
從檔案中途才開始的有色雜訊,會被當成語音。雜訊要涵蓋檔案大約 85% 以上,才會成為雜訊底。在一段四秒的安靜錄音裡,0.6 秒時打開的風扇會被忽略;0.7 秒時打開,就會被報成從 0.63 秒到結尾都是語音,2 秒時打開則是從 1.93 秒開始。請在背景改變的地方把檔案切開,再對每一段分別執行 vad。
平坦度是對整個頻譜量的,只佔據其中一部分的雜訊,頻譜也一樣不平。在安靜的房間裡單獨出現時,一段 0.5 秒、500 Hz 以下的低頻隆隆聲,和一段 0.15 秒、3.5 kHz 以上的嘶聲,都被報成語音。只有分布在整個頻帶上的雜訊才過不了平坦度檢驗,這也是 2 秒時打開的白雜訊沒有被回報的原因。
緊貼著字詞的寬頻雜訊會被併進去,這是子音規則在做它該做的事:一陣在母音開始處結束的白雜訊,成了那個母音區段的一部分。兩者之間隔 0.4 秒時,它就被丟掉了。
用 f0 追蹤音高
f0 透過 librosa 執行 pYIN(Mauch & Dixon 2014),回傳一個 PitchTrack。它比 vad 花的時間多得多:在我的電腦上,一分鐘 16 kHz 的音訊,f0 要 1.3 到 2.6 秒,vad 只要 0.04 到 0.07 秒,所以如果只是想知道檔案裡到底有沒有人聲,用 speech_ratio 問比較快。
y, sr = kudio.file_load("fan.wav")
track = kudio.f0(y, sr)
print(track)
print(len(track), track.hop_length, track.times[75:80])
print(track.f0[75:80].round(1))
median 125.6 Hz  ·  103.8-158.2 Hz (7.3 semitones)  ·  45% voiced
601 160 [0.75 0.76 0.77 0.78 0.79]
[  nan   nan 140.1 140.1 139.3]
向估計器要一個音框的音高,它一定會給一個,靜音、碰撞聲和 /s/ 也一樣,用這些答案連成的曲線,只是一堆雜訊中間穿過一條線。pYIN 還會用涵蓋整個片段的隱藏式馬可夫模型判斷每個音框是不是有聲,所以判斷不會在一個音節裡跳來跳去。track.f0 的單位是 Hz,無聲的音框都是 NaN,所以上面前兩個值是 nan(第一個字的有聲部分從 0.77 秒開始),畫出來的圖也會有缺口;track.voiced 存的是判斷本身。除非你設定 hop_length,否則位移是 10 ms。
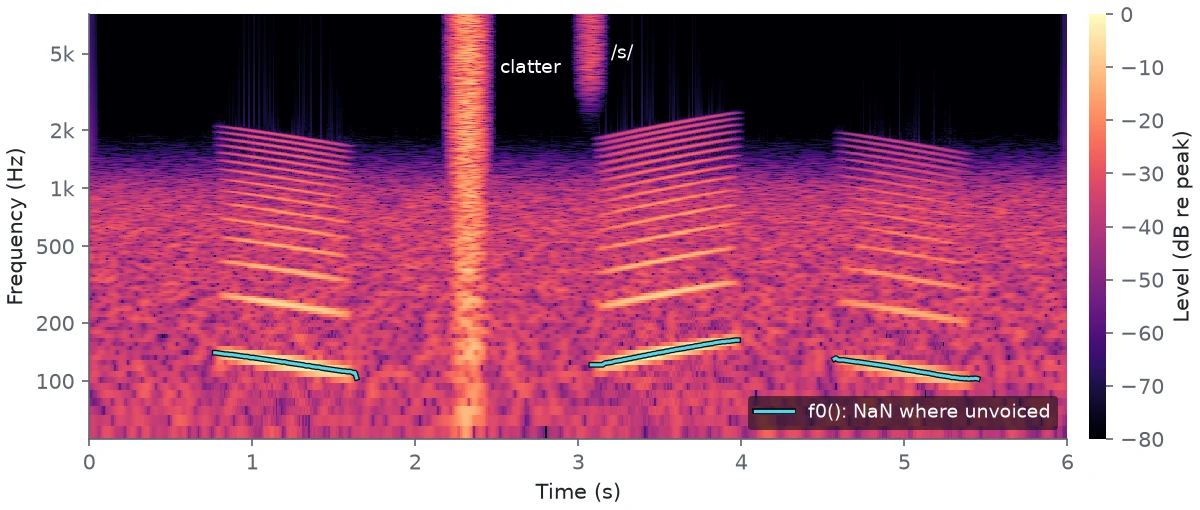
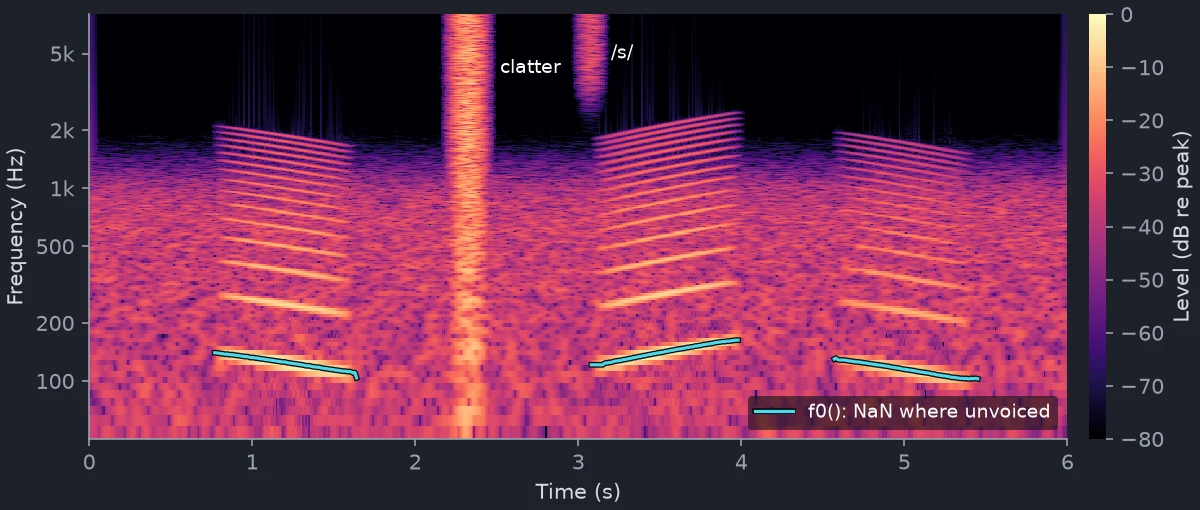
畫在 fan.wav 的頻譜圖上,這條曲線跟著每一段滑音走,在只有碰撞聲、/s/ 或風扇的地方就斷開。
f0 只收一個聲道,和 vad 一樣,遇到多聲道陣列會引發 FeatureError。如果 fan.wav 存成兩個相同的聲道欄,又被當成一個交錯排列的訊號來讀,就會變成長兩倍、音高減半的片段:1201 個音框、中位數 65.0 Hz,對照上面的 601 個音框、125.6 Hz。
pYIN 量的是週期性,不是頻譜圖上最低的那條線。一個 120 Hz 的諧波音通過 bandpass 預設的 300 到 3400 Hz,也就是電話頻帶之後,基頻被壓低 68 dB,讀數仍然是 119.9 Hz。
搜尋範圍本身就是一個決定
預設範圍是 65 到 400 Hz(SPEECH_FMIN 和 SPEECH_FMAX),從低沉的男聲到高亢的女聲。pYIN 只在這個範圍裡找,範圍外的音高不會被報成找不到,而是會被報成範圍裡的某個值:
sr = 16000
t = np.arange(sr) / sr
tone = 0.3 * sum(np.sin(2 * np.pi * 500 * k * t) / k for k in range(1, 10))

print(kudio.f0(tone, sr))                  # the speech range, 65-400 Hz
print(kudio.f0(tone, sr, fmax=1000))       # a range that holds 500 Hz
median 249.7 Hz  ·  249.7-249.7 Hz (0.0 semitones)  ·  100% voiced
median 499.4 Hz  ·  499.4-499.4 Hz (0.0 semitones)  ·  100% voiced
第一行低了一個八度,而且 100% 有聲,看起來沒有任何不對勁。低於範圍時,答案會黏在下限上:50 和 60 Hz 的音都回報成 65.0 Hz,所以中位數剛好落在 fmin 上,就是要注意的徵兆。處理歌聲或小孩的聲音時,請自己用 fmin 和 fmax 設定範圍。
以下情況會在 pYIN 執行前引發 FeatureError:fmin 不在 0 和 fmax 之間、fmax 高於奈奎斯特頻率,以及 frame_length 容納不了超過兩個 fmin 週期,也就是 2 * floor(sr / fmin) + 2 個樣本。不給的話,frame_length 是 2048,在 66.56 kHz 以下都容納得了兩個 65 Hz 的週期,再往上則取夠長的下一個 2 的冪次:88.2 和 96 kHz 時是 4096。kudio pitch 也用同樣的方式選。你自己傳入的 frame_length 只會被檢查,不會被調大。
解讀音高軌跡
print(track) 顯示中位數(median_hz)和第 5 到第 95 百分位數的範圍(range_hz()),因為一次八度誤判或一個判斷錯的音框,就能單獨拉動平均值或決定最小值。summary() 以 dict 回傳同樣的數字,可以直接當成 CSV 的一列。
voiced_ratio 是有音高的音框所佔比例,這和 speech_ratio 不同:/s/ 是沒有音高的語音。即使如此,在 fan.wav 上有聲比例反而比較大,45% 對 43%,因為 vad 在風扇聲中丟掉了小聲的最後一個字的頭尾。
quiet.wav 說明了為什麼要用百分位數。pYIN 的有聲判斷不看準位,它把安靜房間裡 0.46 到 0.55 秒的嘶聲判成有聲,而且剛好是 65.0 Hz。這個值成了最小值,range_hz() 卻仍然從 101.5 Hz 開始。只想保留語音區段內的音高時,請用軌跡的位移去呼叫 vad_frames;兩者預設都是置中的,所以會逐個音框對齊:
y, sr = kudio.file_load("quiet.wav")
track = kudio.f0(y, sr)
speech = kudio.vad_frames(y, sr, hop_length=track.hop_length)
inside = track.f0[track.voiced & speech]       # Hz, voiced and in a vad span
print(track.f0[track.voiced].min(), round(inside.min(), 1))
標籤:在編輯器裡打開結果
一串 tuple 很難用肉眼檢查。把區段轉成 Label 物件,用 to_labels() 把音高軌跡的有聲段落轉成標籤,save_labels 就會把每份清單寫成 Audacity 的標籤軌:
y, sr = kudio.file_load("fan.wav")
speech = [kudio.Label(a, b, f"speech {n}")
          for n, (a, b) in enumerate(kudio.vad(y, sr), 1)]
kudio.save_labels("fan.txt", speech)
kudio.save_labels("fan.voiced.txt", kudio.f0(y, sr).to_labels())
在 Audacity 裡打開 fan.wav,用 File › Import › Labels 加入這兩個檔案;語音區段和有聲段落會成為波形下方的兩條軌。to_labels() 和 voiced_segments() 會略過短於 0.05 秒的有聲段落;min_seconds 可以改這個值。標籤格式,以及用 load_labels 讀回修正過的標籤軌,都在編輯與效果。
kudio pitch fan.wav --segments --labels fan.voiced.txt 一步完成音高的部分:印出摘要行和有聲區段,寫出標籤軌,完全沒有有聲的音框時以 1 結束;見命令列。