品質評估
這一頁的每個指標,都是拿處理過的錄音和它原本那段乾淨錄音比較來評分。沒有乾淨錄音時,檢查錄音裡的檢查還是能用,DNSMOS 也在其中;這一頁的東西則全都需要參考訊號。
其中 SNR、SI-SDR、分段 SNR 和 SDI 這四個,還會拿一個訊號的第 i 個樣本和另一個訊號的第 i 個樣本比。只要延遲一個樣本,完美複本的 SI-SDR 就會掉到+11.9 dB,只比這一頁的降噪器在完全沒有延遲時的分數(+11.7 dB)高一點,而分數裡沒有任何地方告訴你出問題的是延遲。SDR 容得下較晚開始,STOI 容得下大約一毫秒,PESQ 會自己把兩者對齊,但它們也都不會回報延遲。所以要先對齊,再挑指標。
先算一個分數
這一頁的範例共用一段合成片段:兩段由諧波音組成的語句疊在環境音上,中間隔著一段停頓,用 add_noise_snr 以 5 dB SNR 混入白雜訊,再用 spectral_enhance 降噪(見降噪)。所有亂數都給了種子,所以除了 100 dB 以上那些屬於捨入誤差的數字,下面的數字在你的電腦上應該都會一樣。
import numpy as np
import kudio

sr = 16000
rng = np.random.default_rng(0)

def burst(seconds, f0):
    """A harmonic tone that swells four times a second, like syllables."""
    t = np.arange(int(seconds * sr)) / sr
    tone = sum(np.sin(2 * np.pi * f0 * k * t) / k for k in range(1, 12))
    return tone * (0.5 + 0.5 * np.sin(2 * np.pi * 4 * t)) / 6

clean = 0.01 * rng.standard_normal(4 * sr)       # room tone
clean[8000:24000] += burst(1.0, 120)             # two phrases with
clean[32000:52800] += burst(1.3, 150)            # a pause between
clean = clean.astype(np.float32)

noise = rng.standard_normal(4 * sr).astype(np.float32)
noisy = kudio.add_noise_snr(clean, noise, snr_db=5, seed=0)
enhanced = kudio.spectral_enhance(noisy, sr)     # log-MMSE
score 的第一個參數是參考訊號,第二個是要評的訊號,它依名稱執行指標,回傳一個 dict。不給清單時,它會跑這台電腦上能跑的所有指標,在這裡就是 PESQ 以外的全部:
snr、si_sdr、segsnr 和 sdi 純粹用 numpy 計算,除了 kudio 什麼都不用裝。它們也各自是獨立的函式,參數順序相同:snr、si_sdr、segmental_snr 和 sdi。stoi、estoi 和 sdr 需要 kudio[eval];pesq 需要 kudio[pesq],而且取樣率必須是 8 或 16 kHz。指名一個跑不了的指標時,score 會引發例外,而不是把它略過:未知的名稱是 ValueError,缺少套件則是 DependencyError,訊息裡會寫出要安裝的選用套件組。
mir_eval 為什麼限制在 0.9 以下,入門有說明。check_metrics_install 回傳 (pesq_ok, stoi_ok, sdr_ok),也就是這台電腦有哪些後端;每個缺少的後端,它在每個行程裡只記錄一次安裝提示。AudioEvaluate 和 eval_metrics 也會呼叫它,所以請在第一次呼叫它們之前設定好 logging,不然那唯一一次的提示就沒人看得到了。
eval_metrics 是固定形狀的版本,給要拆成三個值的程式碼用:一律回傳 (pesq, stoi, sdr),沒有安裝、無法在這一對上執行,或執行失敗的,就是 None。和這一頁其他所有東西不同,它的取樣率放在第一個:kudio.eval_metrics(sr, clean, noisy) 在這裡回傳 (None, 0.6065905900244255, 5.010295956402773)。
先把兩者對齊
下面是這段片段和自己比的分數,以及 log-MMSE 的輸出和這段片段比的分數,兩者都晚了幾個樣本才開始。兩者的長度都沒變,所以長度檢查沒有東西可以察覺:
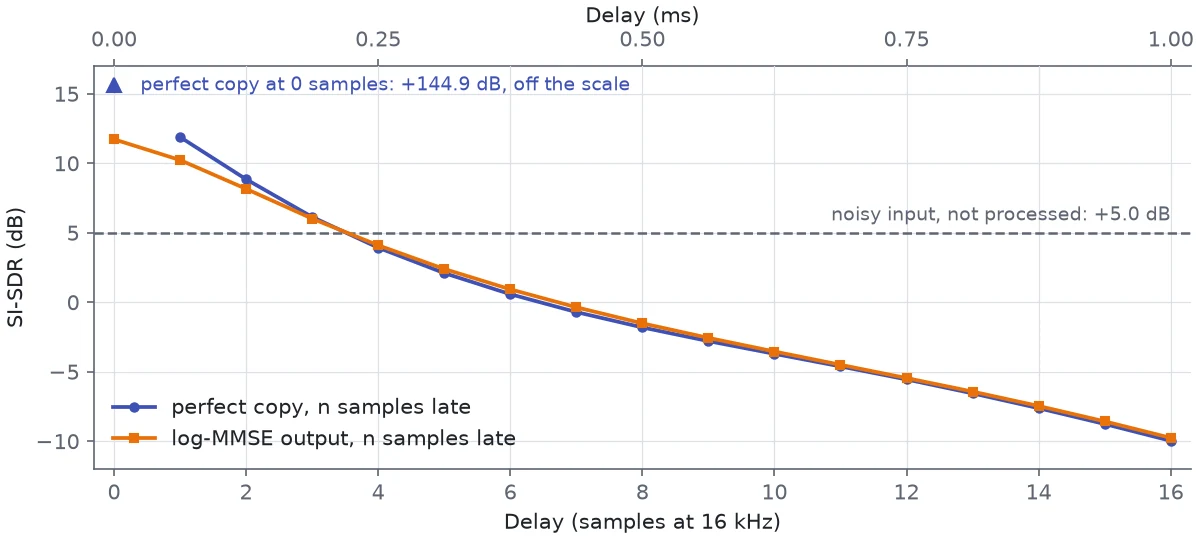
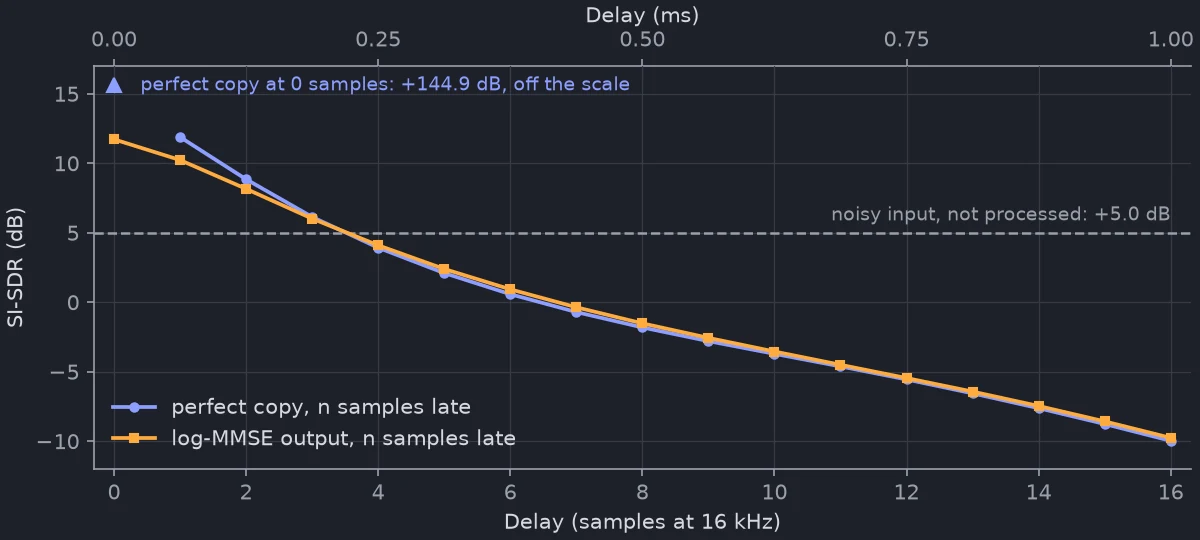
晚四個樣本,在 16 kHz 是四分之一毫秒,這時複本得到 +3.9 dB,降噪後的版本得到+4.1 dB,兩者都比完全沒處理過的含雜訊輸入(+5.0 dB)還低。從三個樣本開始,兩條曲線的差距都在 0.4 dB 以內:分數由延遲決定,降噪的效果幾乎看不出來。不知道有延遲的人讀到這個數字,會以為降噪器比什麼都不做還糟。
延遲的來源都很平常:因果濾波器、重新取樣器、會對輸入音框做 padding 的模型、用喇叭播出來再錄一次的錄音。處理過的檔案比乾淨的長時,長度檢查會發出警告;如果有某個步驟把它裁回輸入的長度,就什麼警告都沒有。
找出延遲
find_delay 用互相關量出延遲,精確到最接近的樣本,align 則回傳裁到共同部分的這一對:
processed = np.concatenate([np.zeros(128, np.float32), enhanced])  # 8 ms late

found = kudio.find_delay(clean, processed, sr)
print(found)

a, b = kudio.align(clean, processed, sr)
print(len(a), len(b), round(kudio.si_sdr(a, b), 2))
同一對不對齊直接評分,會得到 -7.97 dB,外加一則長度不同的警告。
find_delay 回傳的 Alignment 裡,delay 為正代表第二個訊號比較晚開始。相關係數只在重疊的部分上正規化,所以一段長檔案裡只共享一秒的真正配對,分數還是會很高。延遲固定的處理鏈只需要在大聲的段落量一次,之後的每一對都可以用 Alignment.apply 照已經找到的延遲裁切:
other = kudio.add_noise_snr(clean, noise, snr_db=10, seed=0)
other_out = np.concatenate([np.zeros(128, np.float32),
                            kudio.spectral_enhance(other, sr)])

a, b = found.apply(clean, other_out)     # the 128 samples measured above
print(round(kudio.si_sdr(a, b), 2))
拿錯檔案也會得到延遲
互相關一定有最大值,所以 find_delay 對任何兩個訊號都會回傳一個延遲,包括毫不相干的兩個。能區分這兩種情況的是相關係數:低於 MIN_CORRELATION,也就是 0.5 時,align 會拒絕:
leads by 5873 samples (367.1 ms), correlation 0.016, polarity inverted
kudio.exceptions.FeatureError: these do not look like the same recording: best correlation 0.016 at -5873 samples, below 0.5. Aligning them would put a number on two unrelated signals; pass min_correlation=0 to do it anyway.
相關係數只有 0.016 時,那個極性的註記同樣沒有意義。
門檻是我刻意設低的。上面降噪後的版本是 0.968;這個門檻是用來抓出拿錯檔案的情況,不是用來替處理打分數。
通過門檻,也不代表那個延遲就是你要的。語音會重複,在長檔案上不設範圍地搜尋,可能會在半分鐘外找到更好的配對。知道延遲很小時,用 max_seconds= 限制搜尋範圍,設在你預期的最大延遲之上。回傳的是範圍內最好的延遲,就算真正的延遲在範圍外,它還是可能通過 0.5。
極性
極性相反的複本,相關係數是 -1。它是同一段錄音,只是處理鏈中某個環節把它翻過來了。我把這當成一項發現,而不是順手修正掉的東西:find_delay 會回報 polarity inverted,align 則記錄一則警告(設定好 logging 才看得到),並原樣回傳這一對。SI-SDR 看不出翻轉,SNR 看得出來:和 -processed 對齊後,上面那一對的 SI-SDR 仍然是 11.72 dB,SNR 則掉到 -5.77 dB。
單聲道,同一個取樣率
find_delay 和 align 只接受單聲道。立體聲陣列會被拒絕,而不是混成單聲道,因為哪個聲道領先本身就是另一個問題。指標也會以 ValueError 拒絕立體聲,不會把兩個聲道當成一個訊號來評分;請一次評一個聲道,或先混成單聲道。兩個訊號也都必須是你傳入的那一個 sr。不是的時候 find_delay 分辨不出來,所以請先用 resample 把它們調成同一個取樣率。
只有一對檔案時,kudio align clean.wav processed.wav --metrics 會印出延遲,以及對齊前後的 SI-SDR,兩個檔案看起來不像同一段錄音時會以 1 結束(見命令列)。
長度不同時
snr、si_sdr、segmental_snr 和 sdi 會把兩個訊號裁到共同的長度,score 和 eval_metrics 對它們執行的每個指標也一樣。較長那個的尾端永遠不會被比較到,所以只要長度不同,每次呼叫都會發出警告:
UserWarning: ref is 64000 samples and deg 60000: only the first 60000 samples are scored and the rest is ignored. Use kudio.align if the short one is delayed rather than just short, or trim the pair yourself to say which part you meant.
同一行程式碼發出的相同警告,Python 只會顯示一次,所以在迴圈裡處理一堆都被裁掉同樣長度的配對時,只有第一對會警告;warnings.simplefilter("always") 會讓每一次都顯示出來。
當較長那個訊號有超過一半會量不到時,這一對就會被拒絕。沒有這個上限的話,片段的第一秒會被評成整整四秒的完美複本,因為它缺少的那三秒根本不會被看到:
ValueError: ref is 64000 samples and deg 16000: comparing them leaves 48000 of the longer one's 64000 samples unmeasured (75.0%), past the 50% limit, so the score would be about the overlap rather than about the pair. Check that these two are the same utterance, line them up with kudio.align, or raise kudio.core.evaluator.MAX_LENGTH_MISMATCH to score them as they sit.
這個上限是 MAX_LENGTH_MISMATCH,也就是較長訊號的 0.5。真實的處理流程在尾端會少掉一兩個視窗,或因為重新取樣器的捨入少掉一個樣本,半個檔案遠遠超過這種程度。每次呼叫都會重新讀取這個常數,所以長度真的差這麼多的一對,可以在設定 kudio.core.evaluator.MAX_LENGTH_MISMATCH = 0.8 之後評分。它必須設在那個模組上:並沒有 kudio.MAX_LENGTH_MISMATCH 這個名稱,指定一個也不會改變任何東西。
AudioEvaluate 會用同樣的方式檢查它讀入的每一對檔案,訊息裡會寫出兩個檔名;單獨呼叫 pesq 也一樣。拒絕時引發的是普通的 ValueError,所以在批次外面包一層攔 KudioError 的 except,是攔不到它的。
每個指標看到什麼
同一段片段,以六種方式劣化,再用六個指標評分:
| 劣化方式 | snr |
si_sdr |
segsnr |
sdi |
stoi |
sdr |
|---|---|---|---|---|---|---|
| 雜訊,5 dB SNR | 5.0 | 5.0 | -2.1 | 0.32 | 0.61 | 5.0 |
| 增益減半 | 6.0 | 138.9 | 6.0 | 0.25 | 1.00 | 283.0 |
| 極性翻轉 | -6.0 | 144.9 | -6.0 | 4.00 | 1.00 | 283.0 |
| 低通,2 kHz | 18.2 | 18.2 | 10.3 | 0.02 | 0.93 | 24.9 |
| 晚 1 個樣本 | 12.1 | 11.9 | 4.6 | 0.06 | 1.00 | 91.3 |
| 晚 1 ms | -1.4 | -10.0 | -2.2 | 1.40 | 0.99 | 53.6 |
產生這張表的腳本
def late(y, n):
    return np.concatenate([np.zeros(n, np.float32), y])[:len(y)]

cases = {
    "noise, 5 dB SNR": noisy,
    "half the gain": 0.5 * clean,
    "polarity flipped": -clean,
    "low-pass, 2 kHz": kudio.lowpass(clean, sr, cutoff=2000),
    "1 sample late": late(clean, 1),
    "1 ms late": late(clean, 16),
}
names = ["snr", "si_sdr", "segsnr", "sdi", "stoi", "sdr"]
for case, deg in cases.items():
    s = kudio.score(clean, deg, sr, names)
    print(f"| {case} | {s['snr']:.1f} | {s['si_sdr']:.1f} | {s['segsnr']:.1f} "
          f"| {s['sdi']:.2f} | {s['stoi']:.2f} | {s['sdr']:.1f} |")
超過 100 dB 的數字,代表指標沒有發現任何問題。在 snr 和 si_sdr 裡,這個數字來自防止除以零的 1e-12,所以會隨片段的能量變動,138.9 和 144.9 是同一個判定。sdr 的 283.0 則是 mir_eval 殘差裡留下的捨入誤差。
snr- 每一種差異都會扣分:雜訊、增益、極性、濾波、延遲。音量只有一半的完美複本得到 6.0 dB。音量本身也是你要評判的一部分時,就用它。
si_sdr- 比較之前,先去掉兩個訊號的平均值和最吻合的增益,所以音量改變或極性翻轉不會扣分,濾波和延遲則仍然會1。評估降噪器時,我第一個看的就是它,因為降噪器不該因為輸出變小聲而被扣分。
segsnr、segmental_snr- 每個音框各算一次 SNR,限制在 [-10, 35] dB 之間,再取平均。透過
score時,音框一律是 512 個樣本、位移 256,在 16 kHz 是 32 ms,在 48 kHz 是 10.7 ms;要改的話,segmental_snr接受frame_length=和hop_length=。停頓和語音算得一樣重:在 5 dB 的混音裡,249 個音框中有 116 個落在-10 dB 的下限,大多是語句周圍的環境音,這把平均拉到 -2.1 dB。完美複本剛好得到 35.0,比一個音框還短的片段則得到 NaN。 sdisum((ref - deg)**2) / sum(ref**2),也就是線性尺度的 SNR,10 ** (-snr / 10):0 是完美複本,1 代表誤差和語音一樣多,越低越好。它是對整個輸出計算的,所以殘留雜訊和失真一樣算成誤差,未處理的 5 dB 混音得到 0.32。降噪文獻裡的語音失真指數2,是讓乾淨語音單獨通過濾波器,把雜訊排除在外,未經處理的輸入在那裡得到 0。sdi只能和用同樣方式算出的數字比較。stoi、estoi- 短時客觀可懂度(short-time objective intelligibility)3,透過
pystoi計算。它先把兩個訊號重新取樣到 10 kHz、去掉靜音音框,再比較三分之一八度頻帶裡的短時包絡,所以增益、極性和一毫秒的延遲幾乎動不了它,雜訊則會。它能容忍的也差不多就這些:晚 5 ms 得到 0.85,晚 10 ms 得到 0.63,大約就是 5 dB 雜訊的代價(0.61)。擴充版的estoi在 5 dB 混音上得到 0.31,STOI 則是 0.61。完美複本兩者都得到 1,越高越好。pystoi 在去掉靜音音框之後,需要剩下大約 0.4 秒的音訊;不到的話,就算是完美複本,它也會回傳 0.00001,這是佔位值而不是分數,所以 kudio 會把這種片段評為 NaN 並發出警告,AudioEvaluate則把它排除在平均之外。 sdr- BSS Eval 的 SDR4,透過
mir_eval計算。它從參考訊號到輸出擬合出最佳的 512 tap 濾波器,只把這個濾波器產生不出來的部分算成失真。增益、極性、低通,以及最多 511 個樣本的延後開始,都會部分或完全被容忍,所以晚一個樣本得到 91.3 dB。這個濾波器是因果的,提早開始的輸出完全享受不到這些:早一個樣本得到 15.2 dB。只拿它和用同樣方式算出的 SDR 數字比較,絕對不要和 SI-SDR 比。
不同的指標,對同一個降噪器的看法也會不一致。在這段片段上,log-MMSE 讓 SI-SDR 增加 6.8 dB(從 4.97 到 11.72),STOI 卻停在原地(從 0.607 到 0.601),ESTOI 甚至下降了,從 0.305 降到 0.276。
PESQ:講清楚是哪一種
PESQ 有兩個標準、兩種尺度,同一個檔案會得到不同的數字。ITU-T P.862 評的是 8 或 16 kHz 的窄頻語音;P.862.2 只評 16 kHz 的寬頻語音。P.862 可以回報原始分數,範圍是 -0.5 到 4.5,也可以經由 P.862.1 對應到 MOS-LQO。P.862.2 只定義了 MOS-LQO。pesq 用 mode= 指定頻寬、用 scale= 指定尺度,而不是不聲不響地替你挑一個;score、eval_metrics 和 AudioEvaluate 則以 pesq_mode= 和 pesq_scale= 把它們傳下去:
mode |
scale |
8 kHz 時 | 16 kHz 時 |
|---|---|---|---|
'auto'(預設) |
'lqo'(預設) |
P.862,MOS-LQO | P.862.2,MOS-LQO |
'nb' |
'lqo' |
P.862,MOS-LQO | P.862,MOS-LQO |
'wb' |
'lqo' |
拒絕 | P.862.2,MOS-LQO |
'auto' 或 'nb' |
'raw' |
P.862,原始分數 | P.862,原始分數 |
'wb' |
'raw' |
拒絕 | 拒絕 |
其他取樣率會引發 ValueError,訊息會叫你先重新取樣。
論文裡只寫「PESQ」的,可能是原始的 P.862 分數,也可能是 MOS-LQO,可能是窄頻,也可能是寬頻,所以把你的數字和它並列之前,先弄清楚是哪一種。數字要放進表格時,我會兩個參數都傳,並在旁邊註明尺度。這兩行都需要 pesq 套件,它要從原始碼編譯(需要什麼,請看入門):
kudio.pesq(clean, enhanced, 16000)                          # P.862.2 MOS-LQO
kudio.pesq(clean, enhanced, 16000, mode="nb", scale="raw")  # raw P.862
pesq 套件回傳的是 MOS-LQO,kudio 再透過 P.862.1 的對應關係反推回原始分數;公式寫在 pesq 的 API 參考裡。兩種尺度之間不是差一個固定值。原始分數 1.0 對應窄頻 MOS-LQO 1.16,2.0 是 1.63,3.0 是 2.82,4.0 是 4.15。兩者在原始分數 1.22 和 3.37 處交叉,在這兩點之間原始分數比較高,所以拿窄頻 MOS-LQO 去和論文的原始 PESQ 比,會讓方法看起來比實際還差。P.862.2 的對應用的是它自己的係數,所以上面這些都不能拿來換算寬頻分數。
整個測試集
AudioEvaluate 替檔案清單評分:乾淨的參考訊號、含雜訊的輸入,以及每個方法一份清單,依位置配對。clean_files[i]、noisy_files[i] 和每個方法的第 i 個檔案,必須是同一段語句。它回報 PESQ、STOI 和 SDR 中有安裝的那些,表格則需要 pandas(kudio[data])。
files = {"clean": [], "noisy": [], "logmmse": [], "wiener": []}
snr_of = {}
for snr_db in (0, 5, 10):
    mix = kudio.add_noise_snr(clean, noise, snr_db=snr_db, seed=0)
    takes = {"clean": clean, "noisy": mix,
             "logmmse": kudio.spectral_enhance(mix, sr, "logmmse"),
             "wiener": kudio.spectral_enhance(mix, sr, "wiener")}
    for name, wave in takes.items():
        path = f"eval/{name}_{snr_db}dB.wav"
        kudio.save_wave(path, wave, sr)          # creates eval/
        files[name].append(path)
    snr_of[files["noisy"][-1]] = snr_db

ev = kudio.AudioEvaluate(files["clean"], files["noisy"],
                         pesq_mode="nb", pesq_scale="raw")
ev.eval("logmmse", files["logmmse"])
ev.eval("wiener", files["wiener"])
print(ev.get_df())
第一次 eval 也會拿同樣的參考訊號,替含雜訊的檔案評一次分,get_df 把它們放在最後,作為 Baseline 那一列。每個值都是所有檔案的平均,取到小數第四位。裝了 pesq 套件時,表格會多一欄 PESQ;這次執行沒有裝。每一輪也會在 stderr 畫一條 tqdm 進度條,怎麼關掉請看入門。
某個指標在某個檔案上失敗時,那個檔案會得到 NaN,並記錄一則警告,然後被排除在平均之外,而不是讓整欄都失效。完全無法評分的檔案,例如讀不了、取樣率和參考訊號不同,或超過長度上限,每一欄都是 NaN,並有一則寫出檔名的警告,清單裡其餘的檔案照樣評分。Baseline 那一列是對最後一個方法評過的檔案取平均,所以有 NaN 檔案的方法,請在 per_file 裡和 Baseline 比較,不要在這張表裡比。
per_file 裡,每個方法的每個檔案各一列,包含 Baseline,分數旁邊還有 clean、noisy 和被評分的 file 路徑,所以可以依你對每個檔案所知道的任何資訊,把結果拆開來看:
table = ev.per_file()
table["snr_db"] = table["noisy"].map(snr_of)
print(table.pivot(index="snr_db", columns="method", values="SDR").round(2))
Wiener 在 0 和 5 dB 領先,log-MMSE 則在 10 dB 領先。用 Synthesizer 建立的資料集,可以在 noisy 欄上和它的 manifest 合併,manifest 記錄了每份混音的雜訊、SNR、房間和鏈結(建立含雜訊資料集)。合併時比較的是路徑字串,所以檔案清單請從 manifest 本身建立,在 load_manifest 之後用 [p.noisy for p in pairs],而不是重新列一次資料夾。沒有 pandas 時,ev.rows 以普通的 dict 存放各方法的列。這裡沒有 SI-SDR 欄;要算的話,用 score 對每一對跑迴圈。
要在一段錄音上並排試 kudio 自己的降噪方法,並附上 SI-SDR 和同樣的 PESQ 選項,請看降噪裡的 compare_enhancers。這一頁函式的所有參數,都在 API 參考的指標與對齊。
-
J. Le Roux, S. Wisdom, H. Erdogan and J. R. Hershey, "SDR – half-baked or well done?", ICASSP 2019. ↩
-
J. Chen, J. Benesty, Y. Huang and S. Doclo, "New insights into the noise reduction Wiener filter", IEEE Trans. Audio, Speech, Lang. Process. 14(4), 2006. ↩
-
C. H. Taal, R. C. Hendriks, R. Heusdens and J. Jensen, "An algorithm for intelligibility prediction of time-frequency weighted noisy speech", IEEE Trans. Audio, Speech, Lang. Process., 2011. ESTOI: J. Jensen and C. H. Taal, "An algorithm for predicting the intelligibility of speech masked by modulated noise maskers", IEEE/ACM Trans. Audio, Speech, Lang. Process., 2016. ↩
-
E. Vincent, R. Gribonval and C. Févotte, "Performance measurement in blind audio source separation", IEEE Trans. Audio, Speech, Lang. Process. 14(4), 2006. ↩