編輯與效果
kudio.effects 把音訊編輯器對波形做的事寫成函式:淡入淡出、濾波、剪下與接合、裁切、音量,以及把一段錄音變成好幾段訓練資料的資料擴增。每個函式都接收一個 NumPy 陣列,回傳一個新的陣列:不會寫進你傳入的陣列,也不會把同一個陣列直接交回來,所以對結果做就地修改是安全的。
通道劣化(telephone、dropouts 和 G.711 壓擴器)也在同一個套件裡,另外有自己的一頁:房間與通道。
| 要做的事 | 用 |
|---|---|
| 避免片段在開頭或結尾出現喀聲 | fade |
| 去掉低頻隆隆聲、嗡嗡聲,或某個頻帶以外的所有東西 | highpass、lowpass、bandpass、bandstop |
| 去掉固定的偏移 | remove_dc |
| 剪掉一段,或補進一段 | splice |
| 去掉錄音室錄音或暫態聲音前後的靜音 | trim_silence、split_on_silence |
| 在有雜訊底的錄音裡找出語音 | vad,在語音活動與音高 |
| 依標籤檔標的位置剪開錄音 | load_labels |
| 設定峰值 | normalize、normalize_db |
| 設定聽起來的響度 | normalize_lufs,在檢查錄音 |
| 從一段片段得到更多訓練資料 | pitch_shift、time_stretch、add_noise_snr、reverb、spec_augment |
這一頁用到的檔案
take.wav 是六秒、RMS 0.01 的白雜訊,當作房間的環境音,裡面有兩段有聲語句:1.0 到 2.0 秒,以及 3.5 到 4.8 秒。retake.wav 是要補進去的一段 0.3 秒語句,stereo.wav 是同一段錄音的雙聲道版本,take.txt 則是標出這兩段語句的 Audacity 標籤軌。
import numpy as np
import kudio

sr = 16000

def voiced(seconds, f0):
    t = np.arange(int(seconds * sr)) / sr
    return sum(np.sin(2 * np.pi * f0 * k * t) / k for k in range(1, 12)) / 6

y = 0.01 * np.random.default_rng(0).standard_normal(6 * sr)    # the room
y[1 * sr:2 * sr] += voiced(1.0, 120)
y[int(3.5 * sr):int(4.8 * sr)] += voiced(1.3, 150)
kudio.save_wave("take.wav", y.astype(np.float32), sr)
kudio.save_wave("retake.wav", (0.5 * voiced(0.3, 130)).astype(np.float32), sr)
kudio.save_wave("stereo.wav", np.stack([y, 0.5 * y], axis=1).astype(np.float32), sr)
kudio.save_labels("take.txt", [kudio.Label(0.93, 2.07, "speech"),     # the spans
                               kudio.Label(3.43, 4.87, "speech")])    # vad finds
聲道與取樣率
凡是以秒為單位的函式,都用 sr 接收取樣率。淡入淡出、reverse、remove_dc、crossfade 和 splice 接受單聲道的 (n,) 片段,也接受 (frames, channels) 的片段,並對每個聲道做同樣的事。normalize、normalize_db、gain 和 random_gain 也一樣,所有聲道共用一個增益;如果用迴圈對每個聲道分別呼叫 normalize,每個聲道會各自被拉到自己的峰值,聲道之間的平衡就變了。
濾波器、pitch_shift、time_stretch 和 reverb 也接受 (frames, channels) 陣列,沿著 frames 軸處理,每個聲道各算各的。靜音相關的函式則在同樣的樣本位置切開每個聲道,而且只要有任何一個聲道有聲音,那個音框就算有聲音,所以立體聲錄音的各聲道不會錯開:
import kudio

y, sr = kudio.file_load("stereo.wav", mono=False)        # (frames, 2)
y = kudio.highpass(y, sr)                                # each channel
clip, (start, end) = kudio.trim_silence(y)               # one cut for both
add_noise_snr 只混單聲道訊號,其他的一律拒絕。如果對每個聲道分別呼叫,又用同一段雜訊和同一個種子,每個聲道會加進一模一樣的雜訊;如果各聲道的雜訊應該不同,請給每個聲道各自的雜訊。
splice 和 crossfade 只用 sr 把 duration 換算成樣本數,不會檢查各段的取樣率是否相同,所以請把每一段都用同一個取樣率載入。resample 對立體聲陣列也是沿著 frames 軸處理;取樣率的其他細節在音訊檔案。
淡入淡出
import kudio

y, sr = kudio.file_load("take.wav")
y = kudio.fade(y, sr, fade_in_s=0.01, fade_out_s=0.01)
從較長的錄音裡剪出來的片段,開頭和結尾都落在波形中間,等於一個階躍,而階躍聽起來就是喀聲。兩端預設各 10 ms,長度足以消掉喀聲,又短到聽不出是淡入淡出。fade_in 和 fade_out 各只處理一端。
shape= |
曲線 | 適用情況 |
|---|---|---|
'linear'(預設) |
振幅上的直線斜坡 | 防喀聲的淡化,短到曲線形狀無關緊要 |
'cosine' |
升餘弦,兩端平坦 | 聽得出來的淡化,這樣開始和結束都不會太突兀 |
'exponential' |
從 −60 dB 起在分貝上呈直線,再重新縮放,讓兩端剛好落在 0 和 1 | 緩慢的淡出:在 dB 上均勻,聽起來才均勻 |
淡化比片段還長時會引發 FeatureError;淡入和淡出重疊時也一樣,不會把中間那段同時乘上兩條斜坡。
直流偏移
remove_dc 會減掉每個聲道的平均值。固定的偏移會吃掉動態餘裕(headroom),每個剪接點都會發出一聲悶響。它還可能讓 trim_silence 什麼都裁不掉(見下方)。會漂移的偏移其實是非常低的頻率,而不是偏移,remove_dc 只能去掉它的平均值,剩下的交給高通濾波器:
import numpy as np
import kudio

sr = 16000
t = np.arange(4 * sr) / sr
y = 0.3 * np.sin(2 * np.pi * 200 * t) + 0.025 * t     # drifts from 0 to 0.1

for fixed in (kudio.remove_dc(y), kudio.highpass(y, sr, cutoff=20)):
    print(f"{fixed[:sr].mean():+.4f} {fixed[-sr:].mean():+.4f}")
# -0.0375 +0.0375      remove_dc: mean of the first and last second
# +0.0006 +0.0003      highpass
濾波器
import kudio

y, sr = kudio.file_load("take.wav")
y = kudio.highpass(y, sr, cutoff=80)       # rumble, handling noise
y = kudio.bandstop(y, sr, 45, 55)          # 50 Hz hum; (55, 65) for 60 Hz
y = kudio.lowpass(y, sr, cutoff=7000)      # hiss
四個都是 Butterworth 濾波器,除非你傳 order=,否則都是四階。
| 函式 | 預設 | 用來處理 |
|---|---|---|
highpass |
去掉 80 Hz 以下 | 低頻隆隆聲、手持雜訊、緩慢的漂移 |
lowpass |
去掉 8000 Hz 以上 | 嘶聲,以及以 16 kHz 訓練的模型頻帶以外的一切 |
bandpass |
保留 300–3400 Hz | 電話頻帶 |
bandstop |
去掉 45–55 Hz | 50 Hz 的市電嗡嗡聲 |
lowpass 的截止頻率在奈奎斯特頻率以上時
8000 Hz 的預設值正好是 16 kHz 音訊的奈奎斯特頻率,對 8 和 11.025 kHz 的音訊則在奈奎斯特頻率之上。那上面沒有東西可以去掉,所以 lowpass 會把片段原封不動地交回,但交回的是一份複本。其他濾波器的邊界必須嚴格落在 0 和奈奎斯特頻率之間,頻帶邊界前後寫反時會被拒絕。
預設為零相位
濾波器會先正向跑過片段,再反向跑一次(scipy 的 sosfiltfilt)。反向那一次抵銷了正向造成的相位偏移,所以沒有任何東西在時間上移動,濾波後的複本和原始訊號逐樣本對齊。凡是要和原始訊號逐樣本比較的東西都需要這一點,例如和輸入分開濾波的訓練目標。
跑兩次也會把振幅響應平方。斜率相當於兩倍階數的濾波器;在截止頻率處,訊號會低 6 dB,而不是一般講 Butterworth 時常引用的 3 dB:
import numpy as np
import kudio

sr = 16000
tone = np.sin(2 * np.pi * 1000 * np.arange(2 * sr) / sr)     # at the cutoff
middle = slice(sr // 2, 3 * sr // 2)                         # away from the ends

for zero_phase in (True, False):
    out = kudio.lowpass(tone, sr, cutoff=1000, zero_phase=zero_phase)
    gain_db = 20 * np.log10(np.std(out[middle]) / np.std(tone[middle]))
    print(f"zero_phase={zero_phase}: {gain_db:.2f} dB")
# zero_phase=True: -6.02 dB
# zero_phase=False: -3.01 dB
zero_phase=False 是因果濾波器,只跑一次,就像即時運作的裝置那樣濾波。它對每個頻率的延遲都不一樣:預設的高通會讓 100 Hz 延遲 4.8 ms,1 kHz 延遲 0.03 ms。要模擬之後會即時執行的處理時,就用它。
很短的片段也能濾波:sosfiltfilt 在兩端加的填補會縮小到放得下,只有單一個樣本會被拒絕。
kudio.enhance 裡的 wavelet_low_pass_filter 是降噪器,只是剛好呈低通,不能拿來代替這些濾波器;降噪器在降噪。
剪下與接合
從錄音裡剪掉一段,再用 np.concatenate 把兩邊直接接起來,波形會在接縫處跳一下。splice 則是把每一段的最後 5 ms 和下一段的前 5 ms 交疊混合。
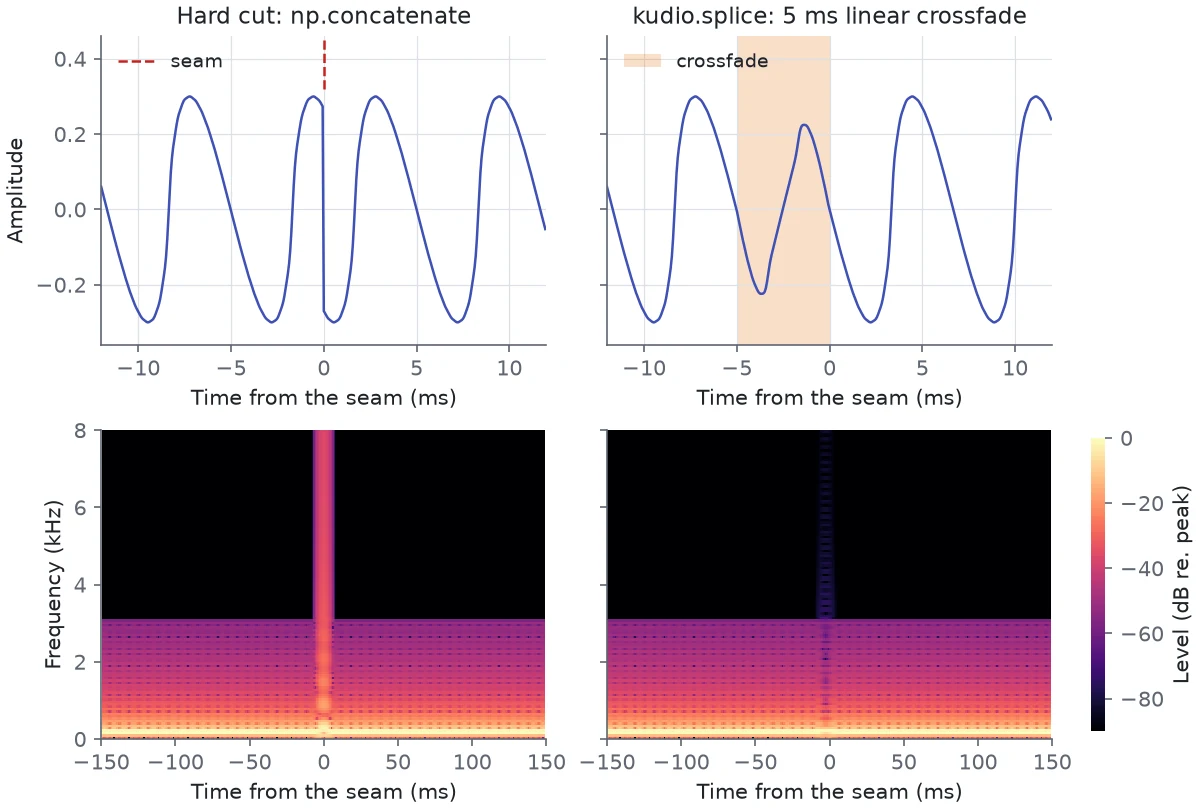
圖中從一個 150 Hz、諧波到 3 kHz 的諧波音裡刪掉 6.5 個週期,所以兩邊接上時錯開了半個週期。直接接起來時,波形在兩個樣本之間跳了 0.54,將近諧波音其他任何地方最大跳動的九倍,頻譜圖上這聲喀聲是一條一路延伸到 8 kHz 的條紋。在 4 kHz 以上,諧波音本身什麼都沒有,條紋卻達到相對峰值 −33 dB。用 splice 接的接縫處,這個頻帶一直在−77 dB 以下。交叉淡化並沒有掩蓋兩邊錯開的事實:在那 5 ms 內兩邊會部分抵銷,造成的是準位下陷,而不是喀聲。
import kudio

y, sr = kudio.file_load("take.wav")
retake, _ = kudio.file_load("retake.wav", sr=sr)    # at the take's rate
a, b = int(1.20 * sr), int(1.45 * sr)               # a cough, say

fixed = kudio.splice([y[:a], y[b:]], sr)                 # cut it out
patched = kudio.splice([y[:a], retake, y[b:]], sr)       # or replace it

print(len(y) - (b - a) - len(fixed))           # 80, at 16 kHz
結果會比各段加起來短,每個接縫短 duration:除非你另外指定,否則是 DEFAULT_CROSSFADE,5 ms,在 16 kHz 是 80 個樣本。重疊的部分由兩段共用,不是額外插進去的。接縫之後的所有東西,都會比單純串接時提早這麼多,所以跟音訊保持同步的標籤或參考訊號也得跟著移。
空的段落會被略過,所以在最開頭或最結尾剪掉時,不會留下一邊什麼都沒有的接縫;交叉淡化比某一段還長時,會縮短到放得進那一段。
線性或等功率
crossfade 用一個接縫接起兩段片段,預設是 shape='equal_power',而 splice 預設是 'linear'。splice 是給同一段錄音裡的兩個時間點用的,crossfade 則是給兩段不同的錄音。在接縫正中間,線性交叉淡化給兩邊的權重各是 0.5,等功率則各是 0.71,所以:
| 接縫兩邊是 | 線性 | 等功率 |
|---|---|---|
| 同一個訊號延續下去 | 準位不變 | 接縫中間最多大聲 3 dB |
| 兩個不相關的訊號 | 接縫中間小 3 dB | 準位不變 |
這 3 dB 實際會出現多少,要看重疊的兩端怎麼對上。把一個振幅 0.5 的正弦波切成兩半,再用預設的 5 ms 接回去:440 Hz 時,等功率的峰值是 0.567;400 Hz 時是 0.695,因為重疊的 80 個樣本剛好是兩個週期,相位一致。線性兩次都維持在 0.500。
依靜音裁切與分段
trim_silence 切掉頭尾的靜音,回傳片段和它保留的樣本範圍。split_on_silence 在每個靜音空檔切開,回傳切出來的各段,但不附上位置。
兩者都只看準位。一個音框的 RMS 比最大聲的音框低 top_db(預設 30)或更多時,就算靜音。音框長 frame_length=2048 個樣本,位移 hop_length=512,單位是樣本而不是秒:在 16 kHz 是 128 ms 和 32 ms。邊界落在位移的格點上,而且往外偏,所以裁切後的片段兩邊都會留一點靜音:
import numpy as np
import kudio

sr = 16000
tone = 0.5 * np.sin(2 * np.pi * 440 * np.arange(sr // 2) / sr)
y = np.concatenate([np.zeros(sr // 2), tone, np.zeros(sr // 2)]).astype(np.float32)

for clip in (y, y + 0.02, kudio.remove_dc(y + 0.02)):
    _, (start, end) = kudio.trim_silence(clip, top_db=30)
    print(start / sr, end / sr)
# 0.448 1.088      the tone runs from 0.5 to 1.0 s
# 0.0 1.5          a DC offset of 0.02: nothing trimmed
# 0.448 1.088
0.02 的偏移比純音的 RMS 低 25 dB,落在 30 dB 的範圍內,所以「靜音」的每個音框都被當成有聲音。請先執行 remove_dc。
在 shell 裡用 kudio trim in.wav out.wav --top-db 30 也能裁切,處理的是檔案混成單聲道後的版本;請看命令列。
背景不是靜音的時候
以最大聲的音框為基準看準位,適用於空檔遠比聲音安靜的情況,例如錄音室錄音,或安靜房間裡的一聲敲擊。在 take.wav 裡,房間的環境音比最大聲的音框低大約 23 dB,所以在預設的 top_db=30 下,每個音框都算有聲音,split_on_silence 會把整個檔案當成一段回傳。把 top_db 調低到環境音被排除為止(這裡是 23),也會切進字詞尾端比較小聲的部分,因為那些部分的準位和環境音差不多。處理語音時,vad、vad_split 和 vad_trim 是拿準位和錄音本身的雜訊底比較,並檢查大聲的音框看起來是不是人聲。語音活動與音高在同一段錄音上把兩種做法都跑了一次。
依標籤剪開
Label 是一段以秒為單位、有名稱的區段,save_labels 會把一串標籤寫成 Audacity 的標籤軌,可以在 Audacity 裡檢查,也能手動移動區段;語音活動與音高用 vad 和 f0 產生標籤,並說明兩種檔案格式。要依標籤檔標的位置剪開錄音,就用 load_labels 讀回來:
import kudio

y, sr = kudio.file_load("take.wav")
for label in kudio.load_labels("take.txt"):
    clip = y[round(label.start * sr):round(label.end * sr)]
    print(label.text, round(label.duration, 2), len(clip))
# speech 1.14 18240
# speech 1.44 23040
把秒換算成樣本數時用 round,不要用 int:2.01 * 16000 算出來是 32159.999…,int 會把它變成 32159,少了一個樣本。
從 Audacity 匯出的標籤軌也能用同樣的方式讀回來。帶有頻率範圍的標籤,Audacity 會多寫一列,以反斜線開頭;load_labels 會略過那一列,因為 Label 只存時間。
音量
normalize 和 normalize_db 設定峰值,分別以滿刻度的比例或 dBFS 表示;靜音的片段則維持不變,不會除以零。gain 和 random_gain 把準位調整固定的 dB 數,或是依種子隨機抽出的 dB 數。四個都保留輸入的 dtype。整數音訊以它自己型別的滿刻度縮放並捨入成整數,增益超過滿刻度時會在滿刻度削峰,而不是溢位繞回。濾波器、淡入淡出、交叉淡化、remove_dc、time_stretch 和 pitch_shift 對整數音訊也是這樣處理:濾波器的過衝,或等功率接縫多出來的 3 dB,都會停在滿刻度,不會繞回變成相反的正負號。
峰值完全看不出片段聽起來多大聲,因為一個突兀的喀聲就能決定峰值。要讓片段聽起來一樣大聲,請用 normalize_lufs,它依 ITU-R BS.1770-4 量測響度;檢查錄音用一段含一聲喀聲的片段示範兩者的差別。
資料擴增
這些函式刻意改變一段錄音,好從中得到更多筆訓練資料。含有任何隨機成分的函式都接受 seed,同一個種子會回傳同樣的陣列;pitch_shift、time_stretch 和 reverb 沒有任何隨機成分。
音高與速度
pitch_shift 把音高移動 n_steps 個半音,長度不變;time_stretch 依 rate 改變長度(大於 1 是變快),音高不變。兩者都來自 librosa。拿一秒鐘、f0 量出來是 200.5 Hz 的 200 Hz 諧波音來試,n_steps=2 會在同樣的 16000 個樣本裡得到 225.0 Hz(升兩個半音應該是 225.1),rate=1.25 則得到 12800 個樣本,音高仍是 200.5 Hz。
以指定 SNR 加入雜訊
add_noise_snr 以 snr_db 把 noise 混進 y。比片段短的雜訊會重複鋪滿;比較長的雜訊則從隨機位置截取,這個位置是其中唯一的隨機成分,所以只有雜訊比較長時 seed 才有作用。雜訊在縮放前會先減去平均值,所以如果雜訊在用到的那一段裡是靜音或常數,就沒有東西可以縮放,不管 SNR 多少都會把 y 原封不動交回;遇到這種情況它會改為引發 FeatureError。兩個訊號都必須是單聲道,立體聲陣列會被拒絕,而不是沿著錯的軸混音。整數音訊以它自己型別的滿刻度混音,回傳時維持原本的型別,並經過捨入和削峰。
import numpy as np
import kudio

sr = 16000
y = (0.3 * np.sin(2 * np.pi * 220 * np.arange(2 * sr) / sr)).astype(np.float32)
noise = np.random.default_rng(0).standard_normal(10 * sr).astype(np.float32)

mix = kudio.add_noise_snr(y, noise, snr_db=5, seed=0)
print(round(kudio.snr(y, mix), 2))                                     # 5.0
print(np.array_equal(mix, kudio.add_noise_snr(y, noise, 5, seed=0)))   # True
SNR 是對整段片段量的,包含停頓。一段一半是靜音的片段以 5 dB 混音時,有聲音的那一半會高 3 dB,大約是 8 dB,因為靜音的那一半讓整段的平均訊號功率減半。整份語料庫的話,Synthesizer 會替每個檔案用各自的種子混音,並記下每個檔案是由哪些來源混成的;請看建立含雜訊資料集。
殘響
reverb 是一個梳狀濾波器:片段本身加上它的七個回聲,間隔 delay_ms(預設 50 ms),每一個是前一個的 decay 倍(預設 0.3,也就是小 10.5 dB)。輸出和輸入一樣長,所以會延續到結尾之後的回聲(預設下最多 350 ms)會被截掉,輸出也經過縮放,讓峰值和輸入的峰值相同。它聽起來像不斷重複的回聲,不像房間:rt60 從它的脈衝響應量出 T30 0.32 秒,並補一句衰減不是直線。資料擴增需要聽起來像房間,或你得說明是哪個房間時,請用 rir 和 apply_rir,在房間與通道。
SpecAugment
spec_augment 會把頻譜圖上隨機的帶狀區域遮掉:最多 freq_mask_width 個頻率格(8)和最多 time_mask_width 個音框(16),預設各一條。每條的寬度是從 0 到最大值之間抽出來的,所以遮罩可能是空的。
它把頻譜圖當成 (frames, bins) 來讀,也就是 kudio 自己由 waveform_to_spectrogram 和 STFT.forward 產生的頻譜圖的排列方式:
import kudio

y, sr = kudio.file_load("take.wav")
spec = kudio.waveform_to_spectrogram(y)                  # (frames, bins)
masked = kudio.spec_augment(spec, seed=0)                # the default widths
被遮掉的格子會填入頻譜圖的平均值,這和 SpecAugment 論文的做法相同:論文先正規化成零平均,再用零遮罩1。如果改成用零去遮未正規化的 log10 功率,不管是什麼片段,都等於功率 1,比它蓋住的幾乎所有東西都亮,所以預設用平均值;要用其他值就傳 mask_value=。
參數在哪裡
這裡每個函式的所有參數,都在 API 參考的編輯與效果底下;Label 和標籤檔則在資料集。
-
D. S. Park et al., "SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition", Interspeech 2019. ↩