錄音與即時檢視
kudio 大部分的功能,處理的都是已經存成檔案的音訊。這一頁談的是還在進來的音訊:從麥克風或網路上的裝置取得,在錄音進行中把它畫出來或降噪,以及播放。
哪些需要 audio 選用套件組
kudio 透過兩套 PortAudio 的 Python 繫結存取硬體,而且每一套都只在需要時才匯入,所以兩套都沒裝,import kudio 也能用。PyAudio 只提供 Windows 的 wheel;Linux 和 macOS 要建置它需要什麼,入門有說明。表格最後一列的類別兩套都不需要,核心安裝就能執行。
| 後端 | 用到它的功能 |
|---|---|
| sounddevice | record、list_devices、play_audio |
| PyAudio | StreamRecorder、Recorder、LocalStreamReader、RemoteStreamReader、CheckDevice、播放開啟中 wave.Wave_read 的 play_audio,以及沒有 sounddevice 時播放其他任何東西的 play_audio |
| 都不需要 | SpectrogramStream、StreamEnhancer、AudioBuffer、FetchBuffer |
沒有這組套件時,這裡所有需要繫結的功能都會引發 DependencyError,訊息會寫出 kudio[audio];它同時也是 ImportError。在沒有 PortAudio 函式庫的 Linux 電腦上裝了 sounddevice,不算缺少選用套件組,因為 pip 修不了,所以這時引發的是 DeviceError,訊息寫出的是要裝的系統套件。
用 record 錄固定長度
record 在整段錄音期間都會阻塞,錄完才回傳:
import kudio

y = kudio.record(seconds=3, sr=16000)          # blocks for 3 s
kudio.save_wave("take.wav", y, 16000)
結果是 float32,共 int(seconds * sr) 個樣本,單聲道的形狀是 (n,),其他則是 (n, channels),和 file_load 及 save_wave 用的排列方式相同。知道自己要錄多久的腳本,這樣就夠了。坐在麥克風前的人就不夠,因為在呼叫回傳之前什麼都看不到。
錄到你喊停為止:StreamRecorder
StreamRecorder 在 PortAudio 自己的執行緒上擷取,保留每一個樣本,你的程式碼隨時都可以問它目前的狀況。說話的人開口之前就看得到準位,句子講完,錄音也跟著結束。當成 context manager 用時,它在進入時開始,離開時關閉串流;在 GUI 裡則改由「錄音」和「停止」按鈕呼叫 start() 和 stop()。
import time

import kudio

with kudio.StreamRecorder(sr=16000) as rec:
    print(f"{rec.sr} Hz, {rec.channels} channel(s)")   # what the device agreed to
    while rec.elapsed() < 5.0:                         # or until someone clicks Stop
        print(f"\r{rec.level_db():6.1f} dBFS", end="")
        time.sleep(0.1)
y = rec.stop()                                         # float32, (n,) for mono
kudio.save_wave("take.wav", y, rec.sr)
sr= 只是一個要求。裝置不接受時,kudio 會依序試 16000、22050 和 44100 Hz,再試裝置自己的預設值,以 INFO 等級記錄選了哪一個,然後繼續;沒給 sr 時,也是同樣的搜尋。所以向一個能以 48、44.1 和 16 kHz 開啟的裝置要求 96 kHz,實際會以 16 kHz 錄音。channels= 超過裝置有的聲道數時,會退回單聲道並發出警告。rec.sr 和 rec.channels 才是錄音實際的格式,存檔時請用它們。輸入完全打不開時,會引發 DeviceError。
錄音進行中,以下這些可以從任何執行緒安全地呼叫:
| 呼叫 | 回傳 |
|---|---|
level() |
最近一個區塊的峰值,線性的 0 到 1 |
level_db() |
同一個值換成 dBFS,數位靜音是 -inf |
elapsed() |
到目前為止擷取了幾秒 |
tail(seconds) |
最近 seconds 秒的音訊 |
drain() |
上一次 drain() 之後的所有音訊 |
take() |
到目前為止的全部,不會停止錄音 |
準位是峰值,所以它告訴你錄音離削峰有多近,而不是聽起來多大聲;聽起來多大聲,請在錄完之後用 loudness 量(檢查錄音)。一個區塊是 frame_size 個樣本(預設 1024,在 16 kHz 是 64 ms),所以讀數大約每秒更新 15 次。
第二次呼叫 stop() 會回傳同一段錄音,不是空陣列。stop() 也會關掉錄音器的 PyAudio 實例,之後再 start() 會用同樣的設定重新開啟串流,接著錄同一段,就像「暫停」按鈕一樣。如果裝置重新開啟時的取樣率或聲道數不同,start() 會引發 DeviceError,而不是把兩段接成一段;reset() 會把目前的錄音丟掉,所以要錄新的一段,請先呼叫它。它在開啟中的串流上也能用,而且會繼續錄音。我把錄音長度的上限設為 max_seconds(預設 3600,None 表示不設上限),免得一台忘了關的錄音器把記憶體塞滿:16 kHz 單聲道 float32 錄一小時是 230 MB。到達上限時,錄音不再增長,capped 會變成 true,但準位仍會持續更新,所以畫面上的音量表不會凍結。monitor=True 會在錄音時把輸入從預設輸出播出來。
顯示用 tail(),其他都用 drain()
tail(seconds) 是滑動視窗,所以相隔十分之一秒的兩次呼叫,回傳的樣本大部分相同,適合每次計時器觸發都重畫一次的波形。凡是有狀態的東西,每個樣本都只能拿一次,這正是 drain() 給的:下面的頻譜圖和降噪器,或是邊錄邊寫的檔案。用 tail() 餵頻譜圖,重疊的部分會畫兩次,而且畫在錯的時間點;拿它餵降噪器,遞迴估計會在已經看過的音訊上再跑一遍。drain() 交出的是完整的區塊,所以觸發得比區塊到達還快的計時器,偶爾會拿到空陣列,下面的 push() 和 process() 都接受空陣列;reset() 會讓 drain 的位置從頭開始。
選擇裝置
sounddevice 和 PyAudio 對同一批裝置各自編號,所以一份清單裡的編號,在另一份裡可能指向別的裝置,或根本不存在。請傳給每個函式它所用後端的編號:
| 編號來源 | 傳給 |
|---|---|
list_devices()(sounddevice) |
record(device=...) |
CheckDevice().system_devices()(PyAudio) |
StreamRecorder、Recorder、LocalStreamReader |
在 shell 裡,kudio devices 會印出兩份清單,並分別標明編號該傳給誰(命令列)。
不給 device 時,各處挑的輸入不一定相同。record 用的是 sounddevice 的預設輸入,Recorder 用的是 PortAudio 的,但 StreamRecorder 和 LocalStreamReader 會經過 CheckDevice.input_device,它會試過 PyAudio 知道的每個裝置,取最後一個能以輸入開啟的。這個裝置可能屬於 system_devices 沒有列出的 host API,因為 system_devices 只涵蓋 PyAudio 的第一個 host API。所以只要用哪個輸入錄音有差別,就請傳 device。想知道 StreamRecorder 最後選了什麼,請在建立它之前呼叫 logging.basicConfig(level=logging.INFO),kudio 就會記錄裝置的編號、名稱,以及它選的取樣率。
CheckDevice 靠實際開啟裝置,來找出它接受什麼。check_available_rate(device) 會從 192000 到 6000 Hz 的十二個標準取樣率中,回傳開得起來的那些;裝置完全無法以輸入開啟時,回傳 False。check_device() 則跑一輪列出裝置、決定輸入的流程,回傳 True 或 False,原因寫在記錄裡。
即時頻譜圖:SpectrogramStream
STFT 和 waveform_to_spectrogram 都要整段片段。最直覺的即時檢視做法,是每次重畫都對最後幾秒重做一次轉換,但這樣幾乎所有時間都花在重算已經在畫面上的東西:用下面的預設值,視窗寬 375 欄,每秒重畫 20 次時,每次只多出大約 6 欄。SpectrogramStream 每一欄只算一次,在它的樣本到齊時計算,並把最後幾秒存在環形緩衝區裡。
import numpy as np
import kudio

sr = 16000
t = np.arange(2 * sr) / sr
y = (0.5 * np.sin(2 * np.pi * 1000 * t)).astype(np.float32)   # 2 s at -6 dBFS

view = kudio.SpectrogramStream(sr, seconds=3.0)
print(view)
for start in range(0, len(y), 700):        # whatever block size the device uses
    new = view.push(y[start:start + 700])  # the columns this block completed
print(view.columns().shape, view.filled, view.frames_seen)
print(view.latency_seconds, view.column_seconds, round(float(view.latest().max()), 2))
SpectrogramStream(sr=16000, n_fft=512, hop_length=128, 257 bins, 3.00s window)
(375, 257) 247 247
0.032 0.008 -6.02
push() 接受任意長度的區塊,長度為零也可以;還湊不滿一個音框的樣本會先留著,然後回傳這個區塊完成的那些欄,形狀是 (new_columns, bins),單位 dB,最舊的在前。用 1、97、128、512 或 4096 個樣本的區塊,得到的欄逐位元組完全相同(測試套件會檢查這一點),所以畫面不會因為裝置挑的區塊大小而改變。第一欄要等 latency_seconds,湊滿一整個音框(n_fft / sr),之後每隔 column_seconds 出一欄(hop_length 預設為 n_fft // 4)。
columns() 把整個視窗當成一張圖:(n_columns, bins),最舊的一列在最前面,所以轉置之後時間是橫軸,最新的一欄落在右邊。它從第一次呼叫起就是完整寬度,在累積到足夠的音訊之前,左邊填的是 floor_db:如果畫面從零開始長出來,每次重畫都會重新縮放時間軸,看起來會像畫面在抖,而不是錄音剛開始。latest() 只有最新的一欄,也就是一個頻譜,給即時讀數用;freqs 存放每一列的頻率(Hz),用來標示座標軸。
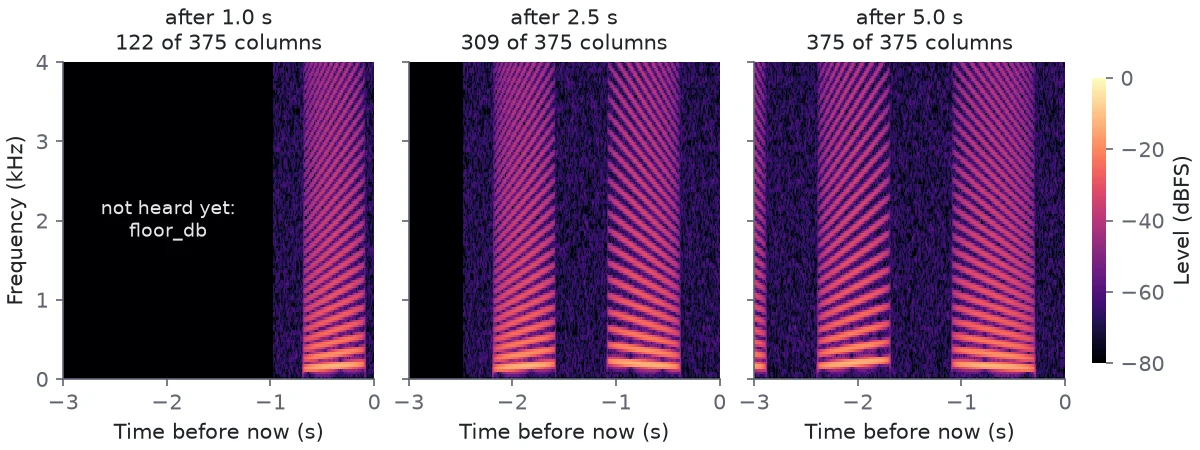
一個合成的串流,以 1024 個樣本的區塊推入,畫了三次。5 秒之後,第一個音節已經從左邊捲出去了。
用 matplotlib 畫出來
SpectrogramStream 沒有鎖。請在同一個執行緒裡推入和繪圖(UI 計時器是最自然的選擇),跨執行緒的部分交給 StreamRecorder,它的 drain() 從哪裡呼叫都安全。有了 matplotlib(kudio[viz])和一支麥克風,整個即時檢視就是這樣:
import matplotlib.pyplot as plt
from matplotlib.animation import FuncAnimation

import kudio

rec = kudio.StreamRecorder(sr=16000).start()
view = kudio.SpectrogramStream(rec.sr, seconds=3.0)

fig, ax = plt.subplots()
image = ax.imshow(view.columns().T, origin="lower", aspect="auto",
                  vmin=view.floor_db, vmax=0.0,
                  extent=(-view.window_seconds, 0.0, 0.0, rec.sr / 2))
ax.set_xlabel("Time before now (s)")
ax.set_ylabel("Frequency (Hz)")
fig.colorbar(image, label="dBFS")


def update(_):
    view.push(rec.drain())
    image.set_data(view.columns().T)
    return [image]


anim = FuncAnimation(fig, update, interval=50, blit=True, cache_frame_data=False)
plt.show()                                 # returns when the window is closed
y = rec.stop()
準位是 dBFS,所以顏色範圍要固定
每一欄都依窗函數做了縮放,所以在線性軸上,滿刻度的正弦波不論 n_fft 和窗函數是什麼,都讀作 0 dB,上面那個半刻度的正弦波則讀作 -6.02 dB。落在兩個頻率格之間的純音,用 Hann 窗最多會低 1.4 dB;這是窗函數的扇形損失(scalloping loss),不是準位改變。比 ref(預設是滿刻度)低超過 top_db(80)的部分,都會被壓到 floor_db,所以空房間畫出來是一片單色,而不是被放大的抖動(dither)。
因為這些數字有意義,即時檢視用 vmin=view.floor_db, vmax=0 來畫,上面那張圖也是。顏色範圍如果跟著數值最大的像素走,沒有人說話時就會把環境音拉到和語音一樣亮,這時畫面就再也看不出任何東西有多大聲。
梅爾軸是拿來看的
n_mels=64 會把各列放到梅爾刻度上,範圍由 fmin 和 fmax 決定。有聲語音大部分的能量在 1 kHz 以下,在 16 kHz 的線性軸上只佔八分之一;用 64 個梅爾頻帶時,有三分之一的列落在那裡。不過梅爾值並不是 dBFS。濾波器用的是 librosa 的,經過面積正規化,所以一個頻帶的值取決於它的寬度,滿刻度的正弦波會讀得遠低於 0 dB:
| 滿刻度正弦波 | 線性軸 | 64 個梅爾頻帶 |
|---|---|---|
| 300 Hz | -0.9 dB | -17.6 dB |
| 1 kHz | 0.0 dB | -18.2 dB |
| 4 kHz | 0.0 dB | -24.1 dB |
80 dB 的下限是在濾波器之後才套用,所以梅爾檢視會因此少掉那 18 到 24 dB 的範圍:用 64 個頻帶時,-70 dBFS 的 1 kHz 純音就已經貼在下限了。梅爾檢視請把 vmax 設在大約 -15,或調高 top_db。freqs 裡的列標籤是各濾波器的中心,不是 fmin 和 fmax:在 16 kHz 用 64 個頻帶時是 46 到 7626 Hz。讀準位請看線性軸,梅爾軸則拿來看說了什麼。
欄沒有置中
離線的 STFT 會在開頭補值,讓第 k 欄以第 k × hop 個樣本為中心。串流沒辦法替還沒聽到的音訊補值,所以這裡第 k 欄涵蓋的是樣本 [k*hop, k*hop + n_fft),也就是 librosa 的 center=False 慣例,測試套件也是拿這個慣例來檢查各欄。因此,即時的一欄會比索引相同的離線欄晚半個音框。to_stft() 會給出對應的 STFT 幾何設定,可以和錄音存在一起;兩者比較時,半個音框的偏移仍然存在。
只接受單聲道
push() 只接受單聲道。二維的區塊,我讓它以 FeatureError 拒絕,而不是攤平,因為把交錯排列的聲道攤平,分析的是一個沒有人錄過的訊號。雙聲道的錄音請先用 y.mean(axis=1) 混成單聲道,訊息裡也是這樣寫的。
邊錄邊降噪
StreamEnhancer 是 drain() 的另一個消費者。把它放在檢視前面,畫面顯示的就是它的輸出。在上面的即時檢視裡,在建立 view 的地方一併建立 enhancer,並修改 update():
enhancer = kudio.StreamEnhancer(rec.sr, "logmmse")   # 32 ms behind at 16 kHz


def update(_):
    view.push(enhancer.process(rec.drain()))
    image.set_data(view.columns().T)
    return [image]
哪些方法能串流處理、延遲從哪裡來,以及 quantile 為什麼不行,降噪都有說明。和 push() 一樣,process() 只接受單聲道,遇到雙聲道的區塊會以 FeatureError 拒絕。請錄單聲道,或在把區塊交給它們之前,先用 block.mean(axis=1) 混成單聲道。
kudio 沒有逐區塊輸出、讓你聽處理結果的功能:錄音器的 monitor=True 播的是原始輸入,play_audio 則是給已經完成的陣列用的。要無間斷地播放處理過的區塊,需要你自己開一個輸出串流,例如 sounddevice.OutputStream。
播放音訊
play_audio 接受陣列加上取樣率、路徑,或開啟中的 wave.Wave_read。大部分失敗的情況,它都會回傳一段訊息,而不是引發例外,所以請檢查回傳值。numpy 的預設 dtype 是 float64,而陣列必須是 int16 或 float32:
import numpy as np
import kudio

tone = np.sin(2 * np.pi * 440 * np.arange(16000) / 16000)    # float64
print(kudio.play_audio(tone, 16000))
tone.astype(np.float32) 就能播;file_load 回傳的本來就是 float32。有安裝 sounddevice 時,陣列會交給它,它在背景播放並立刻回傳,所以如果腳本下一行就結束,聲音會被切掉;sounddevice.wait() 會阻塞到播完為止。沒有 sounddevice 時,陣列改走 PyAudio,它會阻塞到播完。不論走哪一邊,(frames, channels) 的陣列都會用同樣數量的聲道播放。兩個都沒裝時,play_audio 會引發 DependencyError。
路徑用 soundfile 讀取,所以 file_load 打得開的都能播,包括 FLAC 和 FLOAT WAV,讀不了的檔案則回傳訊息。開啟中的 wave.Wave_read 會原樣交給 PyAudio;32 位元整數的檔案在那裡會照 32 位元整數播放,雖然讓 PyAudio 自己判斷的話,它會把這個樣本寬度當成 float32。
較底層的元件
StreamRecorder 建立在 LocalStreamReader 之上,後者用 CheckDevice 決定裝置。下面這些元件,是給它的選擇不合用的時候:要 int16 而不是 float32、要把區塊交給你自己的程式碼,或音訊是從網路進來的。
Recorder
Recorder 是建立在 PyAudio 上、會阻塞的固定長度錄音器,回傳的是 int16 而不是 float32:
import kudio

with kudio.Recorder(record_times=3, rate=16000) as r:   # PortAudio's default input
    y = r.start_record()                       # int16, (n,) for mono
    r.save("take.wav")                         # 16-bit WAV; True or False
它照給定的裝置、取樣率和聲道數開啟,不會改用別的設定:裝置不接受時,start_record() 會引發 PyAudio 的 OSError,而不是 DeviceError。它每次讀取每個聲道 frames_per_buffer(512)個樣本,共讀 int(rate / frames_per_buffer * record_times) 次,所以在 16 kHz 錄三秒是讀 93 次:每個聲道 47,616 個樣本,也就是 2.976 秒。save(resample=...) 會逐聲道對擷取到的內容重新取樣,所以那 2.976 秒在新的取樣率下仍然是 2.976 秒,每個音高也都維持原樣。記憶體裡的陣列,則可以用 resample 沿著 frames 軸做同樣的事:
import numpy as np

x = y.astype(np.float32) / 32768               # y from start_record() above
y8 = kudio.resample(x, orig_sr=16000, target_sr=8000)
kudio.save_wave("take-8k.wav", y8, 8000)
LocalStreamReader
LocalStreamReader 透過 PyAudio 開啟輸入,把每個區塊交給 AudioBuffer、交給 on_frame 回呼函式,或兩者都給:
import time

import numpy as np
import kudio

chunks = []
reader = kudio.LocalStreamReader(device=1,          # a PyAudio index
                                 rate=16000, frame_size=1024,
                                 on_frame=chunks.append)
if reader.get_status():                        # False: no input would open
    device, rate, channels = reader.get_setup()   # what the device agreed to
    reader.stream_start()
    time.sleep(3)
    reader.terminate()
    take = np.concatenate(chunks)              # int16, channels interleaved
每個區塊都是一維的,共 frame_size × channels 個值,各聲道交錯排列:預設是 int16,用 wav_format=kudio.PA_FLOAT32(1,也就是 PortAudio 裡 float32 的格式代號)時是 float32。rate 和 channels 都只是要求,決定的方式和 StreamRecorder 一樣。get_setup() 回傳實際開啟的設定,terminate() 執行過之後則回傳 None,所以要在那之前問。裝置打不開時,這裡不會引發例外:讀取器會維持未初始化,get_status() 會反映這一點,讓 GUI 可以提供重試。對這樣的讀取器呼叫 stream_start() 或 play_audio(),會引發 DeviceError。
on_frame 在 PortAudio 的執行緒上執行,所以請把區塊存起來就回傳,處理留到別的地方做。在它裡面引發的例外,kudio 會攔下來並記錄,串流繼續進行。如果不攔,PyAudio 會印出 traceback 並中止串流,一個出錯的區塊就會讓整段錄音結束。
AudioBuffer 和 FetchBuffer
AudioBuffer 是有容量上限的 FIFO,它是拿來監看的,不是拿來錄音的:裝滿 size 個區塊(預設 2)之後,add() 會丟掉最舊的來騰出空間。顯示要的正是這樣:永遠是最新的音訊,不會越積越多。錄音則不要這樣,所以 StreamRecorder 改用 on_frame 收集。這個緩衝區的方法名稱,把區塊叫做 frame。
get() 會阻塞到有區塊到達,或在 timeout 秒後引發 TimeoutError。get_fixed_size_data(n) 會等接下來的 n 個區塊,把它們頭尾相接後回傳。它在區塊進來的當下、還沒有任何東西被丟掉之前就收集,所以取用的一方再慢,也不會讓它少掉區塊,而原本就在等待中的區塊不算在內。它會拒絕 n = 0,因為那樣會永遠等下去,而任何短於一個區塊的長度,int(seconds * sr / chunk) 算出來就是 0;不是整數的數量也會被拒絕。給了 timeout= 時,時間到會引發 TimeoutError,這次擷取也隨之結束,所以不會有東西留下來繼續等,把下一次擷取的區塊拿走。FetchBuffer(buf).get_data(n, timeout=...) 在自己的執行緒上做同樣的等待,每個 FetchBuffer 一次,引發例外的方式也相同;緩衝區之後可以馬上再用。
RemoteStreamReader
RemoteStreamReader 透過 TCP 連到串流原始 PCM 的裝置,例如區域網路上一塊接了麥克風的板子。它以 daemon 執行緒執行,每次讀 frame_size 個樣本("16bit" 每個 2 位元組,"32bit" 每個 4 位元組,也就是 float32),並把每個區塊加進 AudioBuffer:
import kudio

buf = kudio.AudioBuffer(size=16)
remote = kudio.RemoteStreamReader(buf)
if remote.connect_remote_device("192.168.1.50", 5000):
    remote.initialize_params(frame_size=2048, wav_format="16bit")
    remote.start()
    chunk = buf.get(timeout=5.0)               # 2048 int16 samples
    remote.terminate()                         # sends "stop", closes the socket
kudio 不會送任何東西來啟動串流:連線一建立,伺服器就開始送樣本,並且應該在收到文字 stop 時停止,terminate() 在關閉之前會送出它。其他指令用 sock_send() 送,而且要在 start() 之前:讀取執行緒一開始跑,就會讀同一個 socket,回覆可能被當成區塊放進緩衝區。initialize_params 即使在本機不播放任何東西,也會開啟 PyAudio,所以這個類別同樣需要 kudio[audio]。
分成許多小封包的區塊
分段到達的區塊會被拼回來:第一次讀取不足之後,後續的每次讀取只要求這個區塊剩下的部分。拿一台不管區塊從哪裡開始、一律把 40 個區塊切成 1460 位元組小段的本機伺服器來測,40 個全部收到,順序也對。一個區塊如果需要超過 10 次後續讀取(break_count,以讀取次數計,不是秒數),讀取器就會停止,所以對每個區塊分成許多小封包送出的裝置,請在 start() 之前調高 remote.break_count。
參數在哪裡
錄音器、讀取器、緩衝區和裝置檢查,在 API 參考的即時音訊;SpectrogramStream 在 STFT 與特徵,StreamEnhancer 在增強。