入門
這一頁說明怎麼安裝 kudio,把一段錄音從硬碟上的檔案處理成旁邊一個比較乾淨的檔案,最後介紹出問題時決定你會看到什麼的兩樣東西:例外和記錄。
安裝
核心安裝會帶入 numpy、scipy、librosa、soundfile、PyYAML、tqdm 和 PyWavelets。這樣就夠處理檔案、特徵、效果、響度、不需參考訊號的檢查報告、降噪、資料集合成,以及不需要外部套件的那些指標。import kudio 不會匯入下面任何一個選用套件,所以缺少某個選用套件組時,要到你呼叫需要它的函式時才會發現(畫圖工具則是在匯入 kudio.util.visual 的時候),不會提早。
numpy 的版本上限是 2.6 以下。這個限制來自 numba,不是我:librosa 相依於 numba,numba 限制了 numpy 的版本,要求 pip 裝一個比 numba 能接受的還新的 numpy,只會給它一個解不開的問題。numba 的上限往上調時,這裡也會跟著調。
kudio 需要 Python 3.9 以上。CI 在 Linux 和 Windows 上用 3.9、3.11 和 3.13 測試。
選用套件組
凡是會帶進大型、需要編譯或用途很專門的套件,都放在選用套件組裡,需要哪個就指名安裝。加引號是為了避免 zsh 之類的 shell 把方括號當成檔名萬用字元:
| 套件組 | 會安裝 | 用途 |
|---|---|---|
audio |
PyAudio、sounddevice | 錄音與播放:record、StreamRecorder、play_audio、串流讀取器、list_devices |
eval |
pystoi、0.9 以下的 mir_eval | score 裡的 STOI、ESTOI 和 SDR;AudioEvaluate 和 eval_metrics 裡的 STOI 和 SDR |
pesq |
pesq | pesq、score 和 AudioEvaluate 裡的 PESQ(ITU-T P.862 和 P.862.2) |
dnsmos |
onnxruntime | dnsmos,不需乾淨參考訊號的 P.835 主觀分數預測 |
viz |
matplotlib | kudio.util.visual 裡的畫圖工具 |
data |
pandas、openpyxl | AudioEvaluate.get_df 和 per_file、data2xlsx |
all |
audio、eval、dnsmos、viz、data |
除了 pesq 以外的所有執行期套件組 |
[dev]、[check] 和 [docs] 是開發 kudio 本身用的,不是拿 kudio 來做事用的,[all] 也不包含它們。其餘當中有四組要特別注意:
pesqpesq套件在 PyPI 上只有原始碼,所以安裝時要編譯 C 程式碼,需要編譯器:Windows 上是 MSVC Build Tools。我把它排除在[eval]和[all]之外,這樣沒有編譯器的電腦也裝得起來。dnsmos- 這裡裝的是執行環境,不是模型。權重屬於 Microsoft 的 DNS-Challenge,由那邊發布,所以請 clone 那個儲存庫,把它的 DNSMOS 資料夾傳給
model_dir=,或把環境變數KUDIO_DNSMOS_DIR設成它。找不到sig_bak_ovr.onnx時,kudio 會引發FeatureError,告訴你去哪裡取得。 audio- 兩套 PortAudio 繫結,因為 kudio 兩套都用:
record和list_devices用 sounddevice,串流類別用 PyAudio,而兩者的裝置編號各自獨立(錄音與即時檢視)。PyAudio 只提供 Windows 的 wheel,其他平台上 pip 會從原始碼建置,需要 C 編譯器、Python 標頭檔和 PortAudio 的標頭檔:Debian 和 Ubuntu 上是portaudio19-dev和python3-dev,macOS 上是brew install portaudio加上 Xcode 命令列工具。在 Linux 上,sounddevice 另外還需要系統的 PortAudio 函式庫。 eval- mir_eval 維持在 0.9 以下,因為 SDR 用到它的
bss_eval_sources,0.8 已經把它標為棄用,並表示 0.9 會移除。這個提示 kudio 會自己吃掉,因為版本限制已經處理了這件事,呼叫端也沒有什麼要改的。
check_metrics_install 會告訴你這台電腦有哪些指標後端;它回傳什麼,品質評估有說明。
第一次使用
這一段把一段含雜訊的錄音走過一般的流程:看檔案、載入、檢查、降噪、拿結果跟乾淨訊號比對評分,然後存檔。除了核心安裝之外什麼都不需要,另外需要兩個你可以自己產生的檔案:一段前後有停頓、含兩段有聲段落的乾淨訊號,以及同一段訊號以 2 dB SNR 混入白雜訊的版本。
這兩個檔案和首頁導覽用的不是同一組,只是檔名相同。請在空資料夾裡執行下面的區塊,否則下面的數字都對不上。
產生 clean.wav 和 noisy.wav
import numpy as np

import kudio

sr = 16000
t = np.arange(int(4.5 * sr)) / sr


def syllables(start, stop, f0):
    """Harmonics of f0 under a 4 Hz syllable envelope, between two times."""
    inside = (t >= start) & (t < stop)
    tone = sum(np.sin(2 * np.pi * f0 * k * t) / k for k in range(1, 12))
    envelope = 0.5 - 0.5 * np.cos(2 * np.pi * 4 * (t - start))
    return np.where(inside, tone * envelope / 5, 0.0)


clean = (syllables(0.5, 1.75, 120) + syllables(2.5, 4.0, 150)).astype(np.float32)
noise = np.random.default_rng(0).standard_normal(len(t)).astype(np.float32)
noisy = kudio.add_noise_snr(clean, noise, snr_db=2, seed=0)

kudio.save_wave("clean.wav", clean, sr)
kudio.save_wave("noisy.wav", noisy, sr)
add_noise_snr 會把雜訊縮放到你要求的 SNR,語音功率是對整段片段平均,包含停頓。
先看,再載入
import kudio

print(kudio.audio_info("noisy.wav"))
y, sr = kudio.file_load("noisy.wav")
print(y.dtype, y.shape, sr)
audio_info 從檔頭就能回答取樣率、聲道數、長度和編碼。峰值則需要樣本,它會分塊讀取;peak=False 會跳過這一步,不管檔案多大都是瞬間完成。
file_load 回傳 float32,取樣率是檔案本身的,或是你傳入的 sr=。多聲道檔案會混成單聲道,除非你傳 mono=False,這時不論有沒有 sr=,都會以聲道在後的 (frames, channels) 回傳。
檢查
4.50s @ 16000 Hz · peak -5.3 dBFS · -18.4 LUFS · SNR~9 dB · bandwidth 8000 Hz
estimated SNR around 9 dB — the noise floor is close to the content
audio_report 不需要乾淨的參考訊號。它量準位、響度、削峰、直流偏移、靜音、雜訊底,以及內容實際用到多少頻帶,problems 則把值得處理的地方寫成句子。清單是空的,代表它量得到的東西都沒問題。響度是依 ITU-R BS.1770 計算的閘控整合響度,也就是 loudness 單獨呼叫時回傳的數字:片段聽起來有多大聲,這是峰值看不出來的。其他響度工具在檢查錄音。
檔案是用 2 dB 混的,報告卻說 9 dB。兩者都對,只是講的是不同的事。混音 SNR 是把語音對整個檔案平均,包含停頓;報告則把檔案切成 30 ms 的音框,拿響的音框(準位的第 95 百分位數)和安靜的音框(第 10 百分位數)比較。拿它來找出吵的檔案,不要拿來當引用的數字。下一步的圖上標出了這兩個百分位數。
降噪
spectral_enhance 預設使用 MCRA 雜訊估計加上 log-MMSE 增益,回傳的樣本數和輸入完全一樣,所以輸出和輸入逐一對齊。
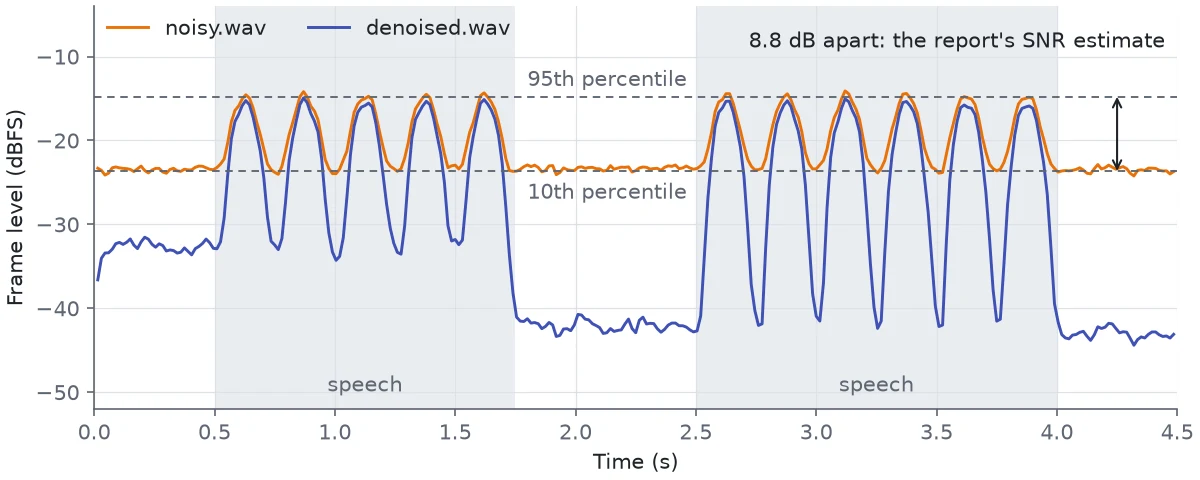
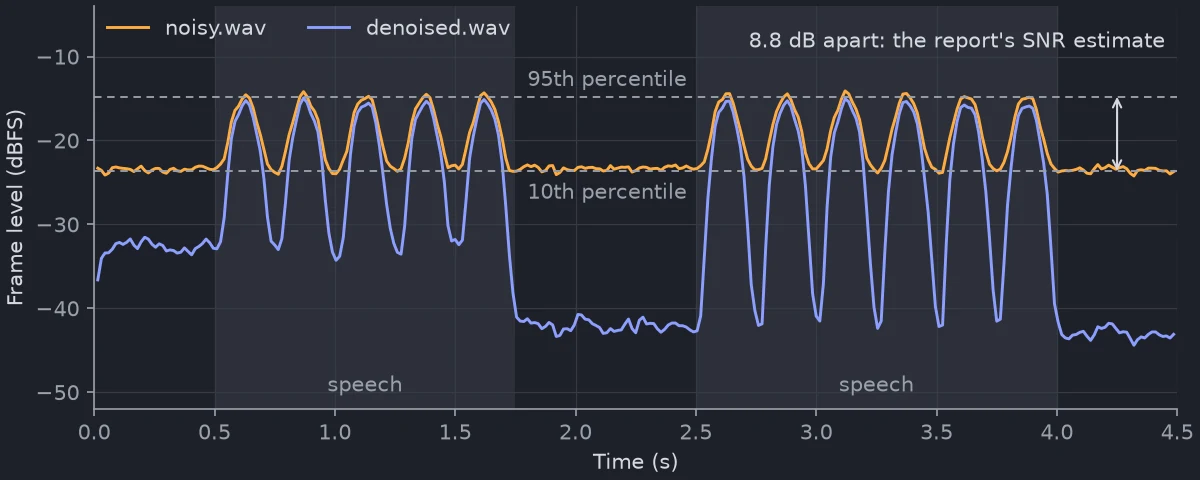
noisy.wav 就是報告量的那個檔案:每個音節的峰值大約 -14.5 dBFS,停頓則在雜訊底-23.6 dBFS。denoised.wav 是上面那個呼叫的輸出,它的雜訊底低了 19 dB,在 -42.8 dBFS,也就是後面兩段停頓所在的位置。音節峰值只掉了大約 1 dB,因為在峰值處,準位主要是語音本身。語音底下的雜訊也降了,只是降得比較少:在兩段有聲段落上,與 clean.wav 的差異從 -23.5 降到 -31.4 dBFS。這個方法只能拿掉它分辨得出不是語音的部分。
最前面半秒留下的雜訊比後面的停頓多大約 10 dB。MCRA 是邊處理邊學雜訊,在那裡還在學。這段片段一開頭是半秒的純雜訊,正好適合 initial 估計器:它把開頭的音框當成環境音,並一直沿用這個估計。
這樣三段停頓都會在大約 -38 dBFS,第一段比用 MCRA 時安靜 6 dB,後兩段則大聲 4 到 5 dB,下一步的 SI-SDR 會從 11.04 dB 變成 12.38 dB。七種增益規則、四種雜訊估計器,以及怎麼比較它們,都在降噪。那一頁也量了降噪從哪裡開始不划算:這段片段以 30 dB 而不是 2 dB 混音時,SI-SDR 仍然增加 8 dB;但那邊的人聲在輸入越乾淨時增加得越少,到 20 dB 時,七種增益規則都會讓它們比原來更差。
跟乾淨訊號比對評分
ref, _ = kudio.file_load("clean.wav")
before = kudio.score(ref, y, sr, ["snr", "si_sdr", "segsnr"])
after = kudio.score(ref, denoised, sr, ["snr", "si_sdr", "segsnr"])
for name in before:
    print(f"{name:7s} {before[name]:6.2f} -> {after[name]:6.2f} dB")
score 以名稱指定指標:snr、si_sdr、segsnr 和 sdi 不需要額外安裝,其他的需要上面的選用套件組。不給清單時,它會跑這台電腦上能跑的所有指標。
這些數字需要乾淨訊號,自己混出來的音檔有,真實的錄音永遠沒有;那正是 audio_report 的用途。它們也是拿第 i 個樣本和第 i 個樣本比,所以可能錯開的一對,要先用 align 對齊。錯開 16 個樣本(1 ms)時,降噪後的片段 SI-SDR 會是 -9.43 dB,而不是 11.04。其餘內容在品質評估。
存檔
save_wave 預設寫 16-bit PCM,除非你傳別的 subtype=;它會建立不存在的資料夾,在整數格式中把超過 ±1.0 的部分削到滿刻度,遇到 NaN 或 inf 則以 AudioIOError 拒絕。格式和原因在音訊檔案。
降噪後的檔案量起來是 -21.6 LUFS,含雜訊的是 -18.4:被拿掉的雜訊本來也算在音量裡。要把兩者並排比聽之前,先用 match_loudness 把它們調到相同響度;原因在檢查錄音。
在 shell 裡做同樣的事
kudio info noisy.wav
kudio report noisy.wav                    # exit status 1: it found a problem
kudio enhance noisy.wav denoised.wav
problems() 不是空的時候,report 會以 1 結束,所以可以當成 shell 腳本裡的測試。所有指令都在命令列。
錯誤
kudio 自己的例外類別都繼承自 KudioError:
| 類別 | 引發時機 |
|---|---|
AudioIOError |
檔案無法讀取或寫入:file_load、audio_info、save_wave 以及建立在它們之上的功能 |
FeatureError |
轉換或量測拒絕它的輸入:形狀不對、太短、未知的方法或參數 |
DeviceError |
StreamRecorder 找不到可用的輸入裝置,或裝了 sounddevice 但系統沒有 PortAudio 函式庫 |
SynthesisError |
Synthesizer 不肯清空存放輸入檔、工作目錄、你的家目錄或檔案系統根目錄的資料夾,或遇到無法設定 SNR 的靜音雜訊或乾淨檔案 |
DependencyError |
缺少選用套件;它同時也是 ImportError |
kudio 裡沒有任何地方會引發 AudioIOError 的子類別 UnsupportedFormatError。soundfile 讀不了的檔案會以 AudioIOError 本身回報,所以請攔截它,例如在批次處理中略過讀不了的檔案:
for path in ["noisy.wav", "missing.wav"]:
    try:
        y, sr = kudio.file_load(path)
    except kudio.AudioIOError:
        print("skipped", path)
訊息裡會寫出檔名和 soundfile 給的原因,soundfile 自己的例外則串接在 __cause__,所以 traceback 兩個都會顯示。
DependencyError 會寫出要安裝的套件組,並把套件名稱和套件組存成屬性。在沒有 [pesq] 的電腦上:
try:
    kudio.score(ref, denoised, sr, ["pesq"])
except kudio.DependencyError as e:
    print(e)
    print(e.extra)
這裡 score 會引發例外,是因為 PESQ 是指名要求的。不給清單呼叫時,它會略過沒裝的指標,eval_metrics 則在那個位置回傳 None。
有三類失敗不屬於 KudioError,或只部分屬於:
- 許多參數檢查,以及少數對資料的檢查,會引發內建的
ValueError或TypeError:score裡未知的指標名稱、長度差太多無法評分的兩個訊號、交給指標的立體聲一對、resample或file_load裡為 0 的取樣率、Synthesizer需要 SNR 清單卻給了字串、沒有任何.wav檔的乾淨資料夾。不存在的Synthesizer輸入會引發FileNotFoundError。except kudio.KudioError一個都攔不到。 - 等待超過
timeout=的緩衝區會引發內建的TimeoutError(錄音與即時檢視)。 play_audio無法播放時不會引發例外,連檔案不存在也一樣。它會回傳一段簡短的訊息說明出了什麼問題,播放成功則回傳None,所以請檢查回傳值。缺少 PyAudio 或 sounddevice 是例外:那是DependencyError,跟其他即時音訊功能一樣。
記錄
kudio 透過標準的 logging 模組記錄,logger 以模組命名(kudio.core.loudness、kudio.core.synth 等等),全部在 kudio 之下。這個 logger 只掛了一個 NullHandler,所以在你的程式設定 logging 之前,kudio 記錄的東西一律不會印出來,連 WARNING 等級也一樣。
會寫進記錄的是例行事務:音訊本身沒有問題,但你可能想留個紀錄。向 check_file 要一個已經被佔用的檔名,又不讓它改名,就是一例:
import logging

logging.basicConfig(level=logging.WARNING)
path = kudio.check_file("noisy.wav", rename=False)
沒有 basicConfig 那一行,同樣的呼叫什麼都不會印。以下情況也一樣:Synthesizer.syn() 清空一個已經有檔案的輸出資料夾、load_waves 或 copy_waves 略過清單裡的某個項目、eval_metrics 略過某個指標後端,以及 align 發現一對訊號極性相反。任何建立資料集的程式,我都會把 logging 開在 WARNING。設好 basicConfig 之後,用這一行就能只加上 kudio 的 INFO 訊息,不會連其他套件的也一起出來:
kudio 指令會自己設定 logging,預設是 INFO,加 -v 則是 DEBUG;這個旗標要放在哪裡,命令列有說明。
有兩類輸出完全不經過 logging:
- 進度條。批次工具(
Synthesizer.syn、AudioEvaluate.eval、mfcc_from_files、logspec_from_files、load_waves、copy_waves、map_waves)會在 stderr 畫 tqdm 進度條。環境變數TQDM_DISABLE=1可以關掉它們。tqdm 從 4.66 版起才讀這個變數,而 kudio 接受 4.60,所以如果變數沒有作用,請升級 tqdm。 - Python 警告。
UserWarning用在音訊或結果本身有問題、即使沒開 logging 也該看到的情況:檔案或陣列裡有 NaN 或 inf 樣本、normalize_lufs把片段推過滿刻度、score把兩個訊號裁到相同長度、片段太短無法算 STOI、Synthesizer寫出超過滿刻度的混音,或在overwrite=False時發現輸出資料夾已有檔案、split_pairs丟掉重複的列。DeprecationWarning標示舊名稱,從 v2 遷移列出了它們。
接下來
| 如果你手上有 | 請看 |
|---|---|
| 一資料夾要轉換、檢查或正規化的錄音 | 音訊檔案、檢查錄音 |
| 一個需要特徵的模型 | STFT 與特徵 |
| 要找出語音,或要追蹤音高 | 語音活動與音高 |
| 要剪接、濾波或擴增的片段 | 編輯與效果 |
| 乾淨語音和雜訊,想做訓練資料 | 建立含雜訊資料集、房間與通道 |
| 要清理的含雜訊錄音,或要評估的降噪模型 | 降噪、品質評估 |
| 一支麥克風 | 錄音與即時檢視 |
| 一個函式,想看所有參數 | API 參考 |