檢查錄音
品質評估上的每個分數,都是拿處理過的片段和乾淨的參考訊號比較。合成的資料集兩者都有;現場錄音只有它自己,而通常要評斷的正是這種錄音。拿降噪後的現場錄音和原本含雜訊的版本比對評分,量到的是降噪改變了它多少,而不是它有沒有變好。所以先來看一個檔案靠自己就能回答的問題:
| 問題 | 該用 | 需要 |
|---|---|---|
| 這是什麼檔案? | audio_info |
核心安裝 |
| 技術上有沒有問題? | audio_report |
核心安裝 |
| 聽起來有多大聲,音量在哪裡變了? | loudness 和它旁邊的函式 |
核心安裝 |
| 聽的人會怎麼評價它? | dnsmos |
kudio[dnsmos],以及 kudio 沒有附帶的模型權重 |
這一頁的範例共用同一段合成錄音,所以在哪裡都能跑:一個 140 Hz、諧波一直延伸到 7.6 kHz 的人聲,時開時關留下停頓,底下墊著 -54 dBFS 的嘶聲。最後一行是讓檔案自己回答它是什麼。
import numpy as np
import kudio

sr = 16000
rng = np.random.default_rng(0)
t = np.arange(20 * sr) / sr
voice = sum(np.cos(2 * np.pi * 140 * k * t) / k for k in range(1, 55))
words = np.sin(2 * np.pi * 0.7 * t) > -0.3          # talk, pause, talk, ...
take = 0.05 * voice * words + 0.002 * rng.standard_normal(t.size)
kudio.save_wave("take.wav", take, sr)
print(kudio.audio_info("take.wav"))
audio_info 從檔頭讀出取樣率、聲道數、長度和編碼,再一次一個區塊掃過樣本找出峰值,不會把整個檔案載入。其餘的內容在音訊檔案,包括在大型語料庫上怎麼跳過這次掃描。
不需參考訊號的健康檢查
audio_report 會量所有不需要乾淨對照版本就能量的東西,回傳一個 AudioReport,它的 problems() 會把發現寫成白話的句子。清單是空的就是好消息。
y, sr = kudio.file_load("take.wav")
report = kudio.audio_report(y, sr)
print(report)
print(report.problems())
它只收單聲道音訊,遇到多聲道陣列會引發 FeatureError。file_load 預設會把各聲道平均,這可能把其中一個聲道的毛病藏起來,所以立體聲檔案請一個聲道一個聲道檢查:用 mono=False 載入,再分別對 y[:, 0] 和 y[:, 1] 產生報告。音框是 30 ms,位移 15 ms,門檻都是固定的,不是參數:
| 欄位 | 量測什麼 | 何時標出 |
|---|---|---|
peak_dbfs |
最大聲的樣本,以 dBFS 表示 | 超過 0、超過 -0.5,或低於 -30 |
clipped_samples、clipped_ratio |
在滿刻度上連成平坦一段的樣本 | 只要有 |
dc_offset |
樣本的平均值 | 絕對值超過 0.01 |
silence_ratio |
比第 95 百分位數的音框低 40 dB 以上的音框所佔比例 | 超過 0.6 |
noise_floor_dbfs |
第 10 百分位數音框的準位 | 不標出 |
estimated_snr_db |
第 95 百分位數的音框準位減去第 10 百分位數的 | 低於 10 dB |
bandwidth_hz、band_limited |
仍帶有內容的最高頻率 | 低於奈奎斯特頻率的 0.9 |
lufs、rms_dbfs |
整合響度(短於 0.4 秒時為 nan)和單純的 RMS |
不標出 |
non_finite_samples |
是 NaN 或 inf 的樣本 | 只要有 |
三個峰值門檻分別代表:已經超過滿刻度、再多一級增益就會削峰,以及用到的位元深度太少。峰值為 -inf(數位靜音),以及有任何非有限值的樣本,這兩種情況都會單獨回報,旁邊不會有其他發現。
削峰
大聲的樣本不等於削峰的樣本。浮點數音訊放大到超過 1.0,波形都還在;傷害是在寫成整數格式時才發生的。削峰是已經被破壞的資訊,看起來像一段平台,所以報告只把這種樣本算成削峰:它所在的那段連續樣本至少有三個,都在滿刻度的 0.999 以上,而且彼此相差不超過 1e-4。碰到 1.0 的一兩個樣本不算;它們會以緊貼上限的峰值出現。
hot = 8 * take                              # float: louder, but intact
for clip in (hot, np.clip(hot, -1.0, 1.0)):
    for problem in kudio.audio_report(clip, sr).problems():
        print(problem)
peaks at +5.5 dBFS, past full scale — it will clip the moment it is written to an integer format
3321 samples clipped (1.04% of the clip) — the recording was already too hot; no processing gets that back
這條連續樣本的規則有兩個盲點。峰值尖銳的人聲被推過滿刻度時,每個音高週期只會削掉一兩個樣本:把這段錄音正規化到 -14 LUFS 再寫成 PCM_16,會這樣失去 2618 個樣本,而對那個檔案產生的報告只會說它的峰值在 -0.0 dBFS。削峰的錄音事後再調小,即使只調 1 dB,平台也會落到 0.999 以下,完全不會被回報。請在寫檔之前執行報告,趁超過 1.0 的樣本還看得到;第二種情況則要自己看波形。
升取樣與頻寬受限的檔案
對資料集傷害最隱蔽的毛病,是 16 kHz 的檔案裡裝著 8 kHz 的音訊:某個時候被升取樣過,4 kHz 以上什麼都沒有,下游的每個環節卻都把它當成寬頻。以標示的取樣率錄下的錄音,雜訊底通常散布在整個頻帶上,所以頻譜會一路延伸到奈奎斯特頻率。升取樣的音訊在舊的奈奎斯特頻率以上則完全是空的。
所以報告用 1024 個樣本的 Hann 窗音框把頻譜平均起來,取和最強頻率相差不到 50 dB 的最高頻率。低於奈奎斯特頻率的 0.9,這個片段就算頻寬受限。這個頻率的兩倍落在某個常見取樣率(8、11.025、16、22.05、32、44.1 或 48 kHz)的 15% 以內時,發現會指出檔案就是從那個取樣率升取樣上來的;否則它直接寫出那個頻率,例如「band-limited to about 3219 Hz」。
narrow = kudio.resample(kudio.resample(take, sr, 8000), 8000, sr)
for problem in kudio.audio_report(narrow, sr).problems():
    print(problem)
content stops at 3797 Hz although the file claims 16000 Hz — it was very likely upsampled from 8000 Hz, and the extra rate is empty
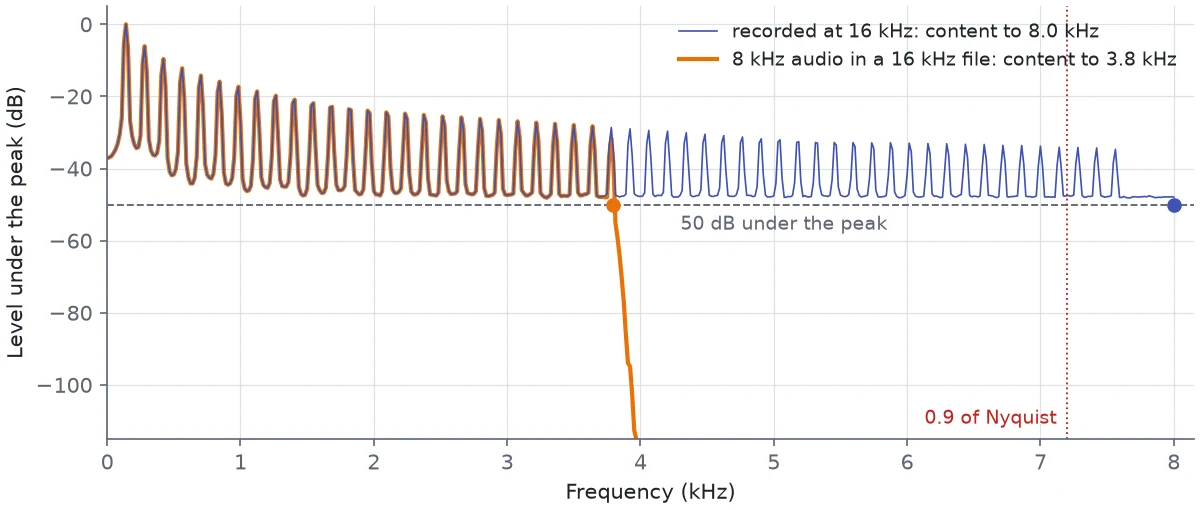
房間與通道裡的 telephone 就是刻意做出這種檔案,報告也用同樣的方式解讀它。這項檢查有兩個前提。內容必須是寬頻的,語音就是:一個 220 Hz 的純音會被報成頻寬受限而且雜訊很多,算術上沒錯,但對誰都沒有用。另外,雜訊底必須落在頻譜最強處的 50 dB 以內。一段乾淨的錄音,如果嘶聲比較小、最高的八度又很安靜,沒有經過任何重新取樣,也會停在奈奎斯特頻率的 0.9 之前:把這段錄音的人聲諧波改成照 1 / k**1.5 而不是 1 / k 衰減,墊在 -66 dBFS 的嘶聲上,就會被報成內容停在 6578 Hz。在安靜、乾淨的檔案上,請把這個發現當成去看頻譜的理由,而不是證據。
一個毛病改變另一個讀數的時候
所有量測都來自同樣的樣本,所以某個毛病有可能動到屬於另一項的數字。直流偏移不會:音框準位是扣掉片段的平均值之後才量的,所以偏移會被回報成偏移,雜訊底則從剩下的部分讀取。削峰就會。它把能量往頻譜上方散開,越過 50 dB 那條線,所以不管檔案經歷過什麼,削峰的檔案看起來都是寬頻:
for label, clip in [("as is", narrow),
                    ("+0.03 DC", narrow + 0.03),
                    ("clipped", np.clip(8 * narrow, -1.0, 1.0))]:
    r = kudio.audio_report(clip, sr)
    print(f"{label:10}  floor {r.noise_floor_dbfs:6.1f} dBFS  "
          f"SNR~{r.estimated_snr_db:3.0f} dB  "
          f"bandwidth {r.bandwidth_hz:4.0f} Hz  band-limited {r.band_limited}")
as is       floor  -57.5 dBFS  SNR~ 31 dB  bandwidth 3797 Hz  band-limited True
+0.03 DC    floor  -57.5 dBFS  SNR~ 31 dB  bandwidth 3797 Hz  band-limited True
clipped     floor  -37.9 dBFS  SNR~ 28 dB  bandwidth 7984 Hz  band-limited False
加了偏移時,problems() 只會多出直流偏移這一項發現,其他都不變;不過還是請用 remove_dc 把偏移去掉,因為它會浪費動態餘裕(headroom)。削峰的複本則不再被認出是從 8 kHz 升取樣上來的,所以不要從削峰檔案的頻寬讀出任何結論。
損壞的樣本
含有 NaN 或 inf 的片段會照樣量測,不會被拒絕:檢查語料庫時,正是你想知道每一個壞掉檔案的時候,而不是在第一個就停下來。
broken = take.copy()
broken[5000:5010] = np.nan
for problem in kudio.audio_report(broken, sr).problems():
    print(problem)
10 samples are not finite (NaN or inf) — the clip is corrupt, not quiet, and every measurement here is meaningless. Repair it or drop it from the set
它排在最前面,而且單獨出現,因為其他檢查不一定會注意到:跟 NaN 比較,不論 NaN 寫在哪一邊,結果都是 false。請看 problems(),不要看欄位;除了這個計數,同一份報告還是給出了 28 dB 的估計 SNR。響度函式會自己檢查,所以損壞的片段絕不會量成靜音的讀數 -inf:loudness 和 true_peak 會回傳 nan 並發出警告,loudness_over_time 得到的曲線會寫著「171 of 171 window(s) unmeasurable」,normalize_lufs 和 match_loudness 則會引發 FeatureError,而不是拿一個不存在的準位去縮放。載入、audio_info 和 save_wave 對這種檔案各有各的處理方式(音訊檔案)。
數字無法告訴你的事
SNR 估計需要含有雜訊的停頓:它從第 10 百分位數的音框讀出雜訊底,而這只有在十分之一的音框除了雜訊什麼都沒有時才成立。人聲出現時,這段錄音的嘶聲比人聲低 27 dB,報告說的是 28。如果像計算混音 SNR 那樣,對整個檔案平均、停頓也算進去,這段錄音是 24.8 dB,這也是為什麼報告的讀數會比檔案混音時的 SNR 高好幾 dB(入門有個例子)。沒有適當的停頓時,最安靜的音框就是語音:
steady = 0.05 * voice + 0.002 * rng.standard_normal(t.size)   # never pauses
clean = 0.05 * voice * words                    # pauses of exact zeros, no hiss
for name, clip in [("no pauses", steady), ("no hiss", clean)]:
    print(f"{name:10} SNR~{kudio.audio_report(clip, sr).estimated_snr_db:.1f} dB")
第一段會被報成「estimated SNR around 1 dB」,而這個發現是錯的:它最安靜的那十分之一音框是語音。在沒有含雜訊停頓的片段上,估計值偏低應該當成未知,而不是當成很差。第二段是乾淨的,也被讀成乾淨:至少十分之一的音框完全是零時,雜訊底就是數位靜音 -inf dBFS,清單上什麼都不會列。語音活動與音高會找出語音在哪裡,降噪則把真正的嘶聲拿掉。另外,空的清單也只是技術上的判定:一個片段可以通過這裡的每一項檢查,聽起來卻還是很差,這就是 DNSMOS 的用途。
一次一整個資料夾
soundfile 打不開的檔案會引發 AudioIOError,空檔案則會引發 FeatureError。兩個都要攔,否則掃到第一個壞檔就會停下來:
from pathlib import Path

for path in sorted(Path("corpus").rglob("*.wav")):
    try:
        y, sr = kudio.file_load(path)
        problems = kudio.audio_report(y, sr).problems()
    except (kudio.AudioIOError, kudio.FeatureError) as e:
        problems = [f"not measured: {e}"]
    for problem in problems:
        print(f"{path.as_posix()}: {problem}")
聽起來有多大聲
峰值幾乎說不出一個片段聽起來有多大聲,因為一個突兀的喀聲就能決定它(編輯與效果示範了它造成的傷害)。loudness 依 ITU-R BS.1770-4 量測聽的人實際聽到的音量,以 LUFS 為單位的閘控整合響度表示:
- 對訊號做 K 加權:一個大約 5 kHz 以上提升 +4 dB 的高頻棚架濾波器,對應頭部的影響;以及一個在 60 Hz 約衰減 3 dB 的高通濾波器,對付低頻隆隆聲。
- 以 400 ms 的區塊計算均方值,每 100 ms 開始一個新區塊。
- 丟掉低於 -70 LUFS 的區塊,再丟掉比剩下部分的準位低 10 LU 以上的區塊。這就是絕對閘門和相對閘門。
- 把剩下的區塊在功率域平均。
這個數字能用,靠的就是閘門。單純的 RMS 每當有人停下來不說話、換成環境音時就會下降;閘控響度不會:
padded = np.concatenate([take, 0.002 * rng.standard_normal(10 * sr)])  # room tone
for clip in (take, padded):
    rms = 10 * np.log10(np.mean(clip ** 2))
    print(f"RMS {rms:.1f} dBFS, loudness {kudio.loudness(clip, sr):.1f} LUFS")
環境音單獨量是 -51.3 LUFS,遠高於 -70 LUFS 的絕對閘門,所以把它排除掉的是相對閘門。
標準只公布了 48 kHz 的濾波器,用教科書上的公式也重現不出來,所以 kudio 透過預扭曲的雙線性轉換,把公布的濾波器帶到其他取樣率;在 16 kHz 和 48 kHz 響應的差距最多 0.07 dB,在 8 kHz 最多 0.29 dB。滿刻度的 1 kHz 正弦波在標準裡是 -3.01 LUFS,這裡在 48 kHz 讀到 -3.004,16 kHz 是 -3.05,8 kHz 是 -3.21。裝了 pyloudnorm([check] 選用套件組)時,kudio 的測試會要求它在 8、16、44.1 和 48 kHz 都和那個獨立的響度計相差 0.1 LU 以內。
多聲道音訊以聲道在後的 (samples, channels) 傳入:最多五個聲道,左、右、中置和兩個環繞聲道的權重分別是 1.0、1.0、1.0、1.41 和 1.41。沒有 LFE 聲道的位置,所以六聲道的檔案會被拒絕。立體聲檔案請先用 mono=False 載入再量測:預設的載入會平均各聲道,兩個聲道相同時讀數會低 3.01 LU,只有一個聲道有訊號時則低 6.02 LU。短於一個 400 ms 區塊的片段會引發 FeatureError,訊息會指向 block_size=;用較小的區塊可以得到一個數字,但那不是 BS.1770 的數字。
正規化到目標響度
normalize_lufs 套用一個能把片段帶到目標響度的增益,預設是 -23 LUFS(EBU R 128),靜音則原樣回傳。除此之外它什麼都不做。被增益推過滿刻度的樣本,回傳時就是超過 1.0,不會被限制,因為限制它們會改變你剛剛要求的響度:
loud = kudio.normalize_lufs(take, sr, lufs=-14.0)
print(f"{kudio.loudness(loud, sr):.1f} LUFS, peak {np.max(np.abs(loud)):.2f}")
發生這種情況時,它會發出 UserWarning,Python 不需要任何設定就會顯示。這樣的片段請用 subtype="FLOAT" 儲存,或把目標設低一點,因為存成 PCM_16 時,它削峰的方式正是報告幾乎察覺不到的那種(削峰)。這則警告只管樣本;樣本之間的真峰值還可能更高。convert_folder 搭配 lufs=-23.0 可以正規化整個資料夾(音訊檔案)。
做 A/B 比較前先對齊兩個版本的響度
比較兩個版本的人,不管品質如何,往往會偏好比較大聲的那個。降噪在拿掉雜訊的同時也會拿掉一些音量,所以沒有對齊響度的比較,有一部分量到的其實是音量的變化。match_loudness 會把一個片段縮放到另一個片段的整合響度:
noisy = take + 0.02 * rng.standard_normal(t.size)
cleaned = kudio.spectral_enhance(noisy, sr)
matched = kudio.match_loudness(cleaned, noisy, sr)
for name, clip in [("noisy", noisy), ("cleaned", cleaned),
                   ("matched", matched)]:
    print(f"{name:8} {kudio.loudness(clip, sr):6.1f} LUFS")
不對齊的話,含雜訊的版本在任何聽測一開始就領先 2.5 LU。取樣率不同的片段也能對齊,用 reference_sr= 即可,因為響度屬於聲音本身,和取樣無關。
響度隨時間的變化
整段錄音一個數字,是正規化時的依據,但要找出有人轉頭離開麥克風的那一刻,它幫不上忙。loudness_over_time 以滑動視窗量測,回傳一條 LoudnessCurve:
drift = take.copy()
drift[8 * sr:13 * sr] *= 10 ** (-12 / 20)          # five seconds facing away

curve = kudio.loudness_over_time(drift, sr)
print(curve)
print(curve.spans_below(curve.max - 6, min_seconds=1.0))
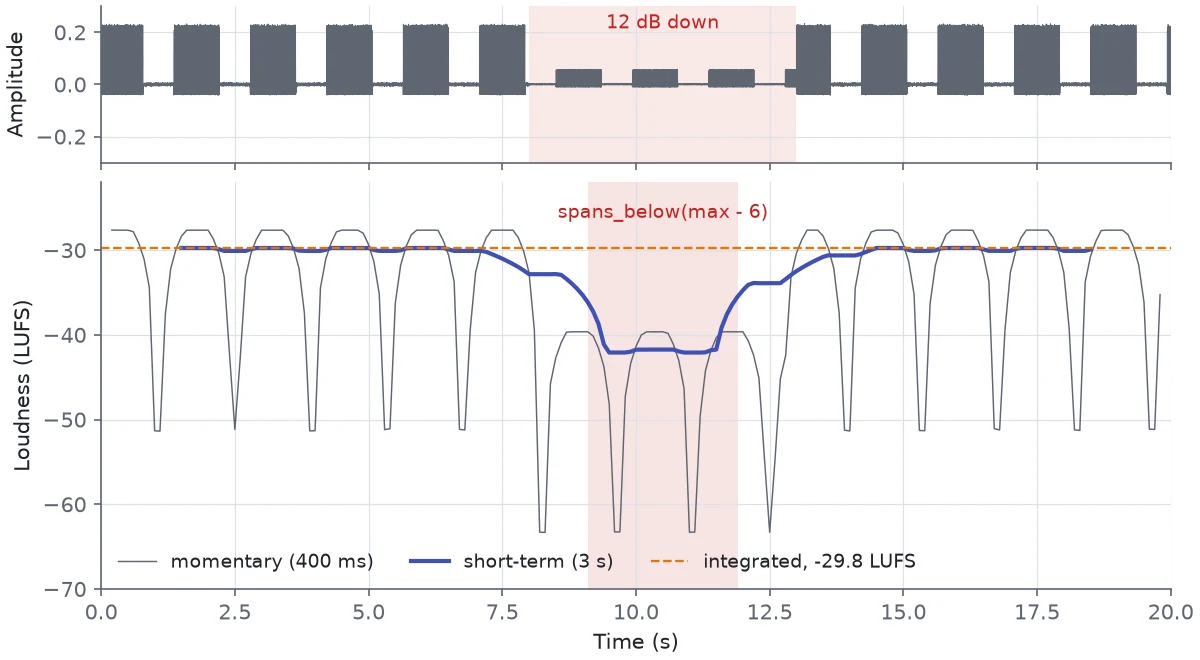
視窗預設是 SHORT_TERM(3 秒),反映的是一個段落有多大聲;MOMENTARY(400 ms)則跟著音節走。這是 EBU Tech 3341 的兩種響度計,其他以秒為單位的長度也都可以;它們一律每 100 ms 前進一步(CURVE_HOP)。短期曲線會跨過停頓,但邊緣比較模糊,把從 8 到 13 秒的下降標在 9.1 到 11.9 秒。瞬時曲線則每個停頓都會往下掉:在它上面,spans_below(max - 6) 會找到那段下降,外加十個 0.3 到 0.4 秒的凹陷,而比凹陷長的 min_seconds=0.5 只會留下那段下降,位置在 8.1 到 12.9 秒。初步檢視一段長錄音,以及使用 loudest() 和 quietest() 時,短期曲線比較穩定。
畫曲線或在曲線上搜尋時,有兩個設計上的選擇要知道。curve.times 存的是每個視窗的中心,而不是像響度計那樣存結尾,所以 3 秒曲線的第一個值在 1.5 秒,和產生它的音訊對齊。另外,曲線沒有閘控,因為閘門作用處留下的空洞,描述的會是一段在字與字之間不存在的錄音。數位靜音的視窗讀數是 -inf,quietest() 會略過它,spans_below() 則把它算成低於門檻。
響度範圍
loudness_range 依 EBU Tech 3342,把短期曲線濃縮成一個以 LU 為單位的數字:它的相對閘門在平均值以下 20 LU,而不是整合響度的 10 LU,而且取的是第 10 到第 95 百分位數之間的分布寬度,所以單單一聲甩門不會決定結果。在 20 秒、峰值 0.3 的穩定純音裡放 20 ms 的滿刻度,只讓它變動 0.03 LU。手上已經有短期曲線的話,range_lu 不必重新量測就能給出同樣的數字:
print(f"{kudio.loudness_range(take, sr):.1f} LU")
print(f"{kudio.loudness_range(drift, sr):.1f} LU, {curve.range_lu:.1f} LU")
真峰值
最大的樣本不等於訊號實際達到的最大值。樣本是一條曲線上的點,曲線會從樣本之間通過,而轉換器、有損編碼器或重新取樣器會把這條曲線重建出來,並在它過衝的地方削峰。true_peak 依 BS.1770-4 附錄 2,用超取樣量測這個過衝,單位是 dBTP。教科書上的例子是一個頻率為取樣率四分之一的滿刻度正弦波,調整相位讓每個樣本都落在 ±0.707:
n = np.arange(sr)
tone = np.sin(2 * np.pi * (sr / 4) * n / sr + np.pi / 4)
tricky = kudio.fade(tone, sr, 0.01, 0.01)
peak = 20 * np.log10(np.max(np.abs(tricky)))
print(f"samples {peak:.2f} dBFS, true peak {kudio.true_peak(tricky, sr):+.2f} dBTP")
這個正弦波在樣本之間會達到 1.0,也就是 0 dBTP,量測結果和它相差不到 0.02 dB。拿掉 10 ms 的淡入淡出,讀數會是 +0.12 dBTP:在 0.707 處突然開始、突然結束的片段,兩端都會振鈴,播放它的轉換器也會同樣振鈴。依照標準的要求,這個量測至少超取樣到 192 kHz,在 48 kHz 是 4 倍,在 16 kHz 是 12 倍。
EBU R 128 允許的真峰值最多是 -1 dBTP。normalize_lufs 只會針對超過滿刻度的樣本發出警告,所以正規化之後請量一下真峰值:
for target in (-23.0, -17.0):
    out = kudio.normalize_lufs(take, sr, lufs=target)
    sample = 20 * np.log10(np.max(np.abs(out)))
    print(f"{target:.0f} LUFS: samples {sample:+.2f} dBFS, "
          f"true peak {kudio.true_peak(out, sr):+.2f} dBTP")
-23 LUFS: samples -6.43 dBFS, true peak -6.14 dBTP
-17 LUFS: samples -0.43 dBFS, true peak -0.14 dBTP
在 -17 LUFS 時,每個樣本都在滿刻度以下,不會發出任何警告,這段錄音卻仍然超過上限。
DNSMOS:聽的人會怎麼說
一段錄音好不好聽是主觀判斷;沒有參考訊號、也沒有聽評小組時,唯一能給出判斷的,是用聽評小組的評分訓練出來的模型。dnsmos 執行 DNSMOS,以 1 到 5 的 MOS 尺度預測 ITU-T P.835 的三個分數,回傳一個 DnsmosScore:SIG 是語音,BAK 是背景有多不干擾,OVRL 是整體。降噪時 SIG 和 BAK 會分開走,因為過度的抑制會連同雜訊把語音也吃掉,只用一個數字就會把這件事藏起來。
權重屬於 Microsoft 的 DNS-Challenge,由那邊發布;kudio 除此之外全是原始碼,我不想在裡面夾帶別人的二進位檔。所以這裡需要兩樣這一頁其他地方都不需要的東西:用 pip install kudio[dnsmos] 裝 onnxruntime,以及從那個儲存庫 clone 下來的一份副本。
score = kudio.dnsmos(take, sr, model_dir="DNS-Challenge/DNSMOS")
print(score.sig, score.bak, score.ovrl)
print(score.summary())
find_dnsmos_model 先找 model_dir,再找 KUDIO_DNSMOS_DIR;兩者都可以直接指定檔案,或指定一個要搜尋的資料夾,子資料夾也會一起搜尋。副本裡有不只一個 sig_bak_ovr.onnx 時,依路徑排序的第一個會被選中,所以在乎跑的是哪一個時,請直接指定檔案。接著:
- 音訊會重新取樣到 16 kHz,也就是模型訓練時的取樣率。
- 音訊切成 9.01 秒的視窗,位移 1 秒,這是模型預期的長度,各視窗的分數再取平均;
score.segments會告訴你平均了幾個。視窗的排法和 DNS-Challenge 的dnsmos_local.py一樣,所以這裡的分數和用那個腳本發表的分數一致:視窗從整數秒開始,並在片段最後一個完整的秒之內結束,所以 10.5 秒的片段得到一個視窗,20 秒的片段得到 11 個,最後 0.99 秒不算在內。那個腳本自己只會評 11 個裡的 7 個:它用浮點數算每個視窗的結尾,從第 7 到第 23 秒開始的視窗會因為捨入而少一個樣本,於是被略過。我把它們留著,所以只要片段在加倍之後仍短於 17 秒,兩者的結果就一致,比較長的片段 kudio 則會評到更多視窗。 - 比一個視窗短的片段會像那個腳本一樣不斷加倍,直到夠一個視窗長,而不是補零,結果裡的每個視窗都會評分:2 秒的片段會變成 16 秒、七個視窗。靜音會被評成毀損的語音,在兩秒的片段後面接上七秒靜音,會回報一個片段本身沒有的問題。
- 每個視窗的原始輸出會先透過
POLYFIT換算到 MOS 尺度再取平均,這是針對非個人化模型公布的多項式,先換算再平均的順序和 DNS-Challenge 的dnsmos_local.py相同。模型旁邊的polyfit.json會取代這些多項式,其他模型都需要這個檔案;polyfit=False則保留原始輸出。
summary() 把 OVRL 4.0 以上稱為 clean,3.0 以上稱為 usable,2.0 以上稱為 poor,再低就是 bad。SIG 和 BAK 相差超過 0.7 時,它會說出是哪一邊比較高:SIG 2.6、BAK 4.1、OVRL 2.9 會得到「poor (OVRL 2.90) — the background is cleaner than the speech, which is what over-aggressive denoising looks like」。
處理整個資料夾時,模型只開一次,再把 session 交給每一次呼叫。這樣就完全不會去查模型資料夾,所以那裡的 polyfit.json 也不會被讀取,套用的是公布的係數:
from pathlib import Path

import onnxruntime as ort

model = kudio.find_dnsmos_model("DNS-Challenge/DNSMOS")
session = ort.InferenceSession(str(model), providers=["CPUExecutionProvider"])
for path in sorted(Path("corpus").rglob("*.wav")):
    try:
        y, sr = kudio.file_load(path)
        print(path.as_posix(), kudio.dnsmos(y, sr, session=session).summary())
    except (kudio.AudioIOError, kudio.FeatureError) as e:
        print(path.as_posix(), f"not measured: {e}")
從命令列
kudio info take.wav                        # header, encoding and peak
kudio report take.wav || echo "needs another take"
kudio loudness take.wav --target -23       # exit 1 when over 1 LU off
kudio report 印出報告和其中的發現,有任何發現就以 1 結束。kudio loudness 印出整合響度、響度範圍、真峰值,以及最大聲和最小聲的時刻;--over-time 會加上曲線,每 100 ms 一行。kudio report 以單聲道讀檔,把各聲道平均;kudio loudness 則保留各聲道,因為 BS.1770 會把各聲道加權後相加,立體聲檔案的單聲道混音會低 3 LU。旗標在命令列,這裡每個函式的所有參數都在 API 參考。