音訊檔案
這一頁的函式都透過 soundfile 讀寫,載入的波形一律是 float32 NumPy 陣列,±1.0 是滿刻度。單聲道音訊是一維陣列。聲道不只一個時,形狀是 (frames, channels),一個 frame 就是每個聲道各取一個樣本:這是 soundfile 的排列方式,也是 loudness 預期的格式。
| 要做的事 | 用這個 |
|---|---|
| 不把檔案載入記憶體,就知道它的取樣率、長度和峰值 | audio_info |
| 載入一個檔案 | file_load |
| 寫出一個陣列 | save_wave |
| 改變已經在記憶體裡的音訊的取樣率 | resample |
從資料夾、清單和 .txt 檔蒐集 .wav 檔 |
check_input |
| 一次載入或複製很多檔案 | load_waves、copy_waves |
| 對整個目錄樹重新取樣、重新編碼、裁切或正規化 | convert_folder |
| 取得一個沒被佔用的檔名或資料夾名稱 | check_file、check_path |
樣本本身的問題,例如檔案裡有 NaN,會以 Python 警告出現,不必做任何設定就看得到。例行事務則是寫進記錄:某個檔名即將被覆寫、某個項目不是 .wav 檔、某個目的地不是資料夾。在你的程式設定 logging 之前,kudio 記錄的東西一律不會印出來,所以跑批次工作之前請先把它打開;logging.basicConfig(level=logging.WARNING) 就夠了(入門)。
範例假設已經 import kudio,而且資料夾裡有下面這段腳本產生的檔案。請在空資料夾裡執行它。
產生範例要讀的檔案
from pathlib import Path

import numpy as np

import kudio

rng = np.random.default_rng(17)


def tone(freq, seconds, sr=16000, amp=0.3):
    t = np.arange(int(seconds * sr)) / sr
    tremolo = 0.6 + 0.4 * np.sin(2 * np.pi * 3 * t)
    y = amp * np.sin(2 * np.pi * freq * t) * tremolo
    return (y + 0.005 * rng.standard_normal(len(t))).astype(np.float32)


kudio.save_wave("clip.wav", tone(220, 3.5, amp=0.45), 16000)
t = np.arange(16000) / 16000
left, right = 0.5 * np.sin(2 * np.pi * 220 * t), 0.5 * np.sin(2 * np.pi * 880 * t)
kudio.save_wave("stereo.wav", np.stack([left, right], axis=1), 16000)
pad = np.zeros(22050, np.float32)                 # half a second at 44.1 kHz
for name, amp in [("spk1/a", 0.05), ("spk1/b", 0.2), ("spk2/a", 0.6)]:
    y = np.concatenate([pad, tone(330, 2.0, 44100, amp), pad])
    kudio.save_wave(f"raw/{name}.wav", np.stack([y, 0.8 * y], axis=1), 44100)
for name in ["incoming/one.wav", "incoming/two.wav"]:
    kudio.save_wave(name, tone(440, 1.0), 16000)
for name in ["dr1/fcjf0/sx133.wav", "dr1/fcjf0/si1027.wav", "dr2/fdml0/sx133.wav"]:
    kudio.save_wave(f"corpus/{name}", tone(200, 1.5), 16000)
for name in ["flac/a/one.flac", "flac/b/two.flac"]:
    kudio.save_wave(name, tone(300, 1.0), 16000)
for name in ["rec.wav", "take.wav", "take.v2.wav"]:
    kudio.save_wave(f"takes/{name}", tone(250, 0.5), 16000)
kudio.save_wave("notes.flac", tone(300, 0.2), 16000)
Path("incoming/broken.wav").write_bytes(b"this is not a wave file")
Path("runs/exp").mkdir(parents=True)
Path("runs/exp2").mkdir()
Path("lists").mkdir()
Path("lists/extra.txt").write_text("corpus/dr1/fcjf0/si1027.wav\n\ncorpus/dr2\n")
載入之前先看
info = kudio.audio_info("clip.wav")
print(info)
print(info.frames, info.duration, info.subtype, info.format)
AudioInfo 裡除了峰值,全部來自檔頭。峰值需要讀樣本,每次讀 2^20 個 frame,所以再長的檔案也不會整個放進記憶體;peak=False 會跳過這次讀取,適合快速掃過大型語料庫,這時 peak 是 None,印出來是「peak not measured」。audio_info 也接受陣列,以聲道在後的方式解讀,而且要傳入 sr=,因為波形本身不帶取樣率。在 shell 裡 kudio info clip.wav 會印出同樣的內容(命令列);樣本透露出這段錄音的哪些狀況,請看檢查錄音。
載入檔案
y, sr = kudio.file_load("clip.wav")               # the file's own rate
print(y.shape, y.dtype, sr)                       # (56000,) float32 16000
y8, sr8 = kudio.file_load("clip.wav", sr=8000)    # resampled on the way in
print(y8.shape, y8.dtype, sr8)                    # (28000,) float32 8000
預設 sr=None 時,file_load 保留檔案本身的取樣率,只透過 soundfile 讀取。指定取樣率的話,檔案改走 librosa,用它的 soxr_hq 重新取樣器重新取樣。搭配 librosa 1.0 時,兩條路徑都能開啟已安裝的 libsndfile 開得了的任何格式;soundfile.available_formats() 會列出這些格式,soundfile 0.14 包括 WAV、FLAC、OGG、MP3、AIFF 和 NIST SPHERE。kudio 仍然接受的 librosa 0.10 和 0.11,在 sr= 這條路徑上遇到 soundfile 打不開的檔案時,會退回去用 audioread,所以用這兩版時,同一個檔案可能加了 sr= 載得進來,不加反而失敗。
預設的 mono=True 會把各聲道平均。mono=False 則保留各聲道,聲道在後,不論檔案走的是哪一條路徑:
y, sr = kudio.file_load("stereo.wav", mono=False)
y8, sr8 = kudio.file_load("stereo.wav", sr=8000, mono=False)
print(y.shape, y8.shape)                          # (16000, 2) (8000, 2)
習慣 librosa 的人請注意
librosa.load(..., mono=False) 回傳的是 (channels, frames)。file_load 把它轉了過來,所以左聲道是 y[:, 0]。y[0] 是所有聲道的第一個 frame,照 librosa 的方式取索引的程式碼照樣能執行,不會引發錯誤,只是讀到的是兩個樣本。
file_load 讀不了檔案時,會改成引發寫明路徑的 AudioIOError,所以一個 except kudio.AudioIOError 就能攔下所有載入失敗。它和 kudio 的每個錯誤類別一樣,繼承自 KudioError。參數錯誤是呼叫寫錯,不是檔案有問題,所以是單純的 ValueError:例如這裡的 sr=0、給 resample 的取樣率為零、給 convert_folder 同時傳 peak= 和 lufs=。
寫入檔案
y, sr = kudio.file_load("clip.wav")
kudio.save_wave("out/clip.wav", y, sr)                        # 16-bit PCM
kudio.save_wave("out/clip24.wav", y, sr, subtype="PCM_24")
kudio.save_wave("out/clipf.wav", y, sr, subtype="FLOAT")      # 32-bit float
kudio.save_wave("out/clip.flac", y, sr)                       # FLAC, by extension
kudio.save_wave("out/clip8k.wav", y, sr, d_sample=8000)       # resampled first
save_wave 會建立不存在的資料夾,已經存在的檔案則直接取代,不會先問;要找沒被佔用的檔名,請用 check_file(見下文)。soundfile 依副檔名決定容器格式,subtype 必須是那個容器接受的:FLAC 接受 PCM_16 和 PCM_24,不接受 FLOAT。
subtype |
儲存方式 | 超過 ±1.0 時 |
|---|---|---|
PCM_16(預設) |
整數,65,536 階 | 削到滿刻度 |
PCM_24 |
整數,16,777,216 階 | 削到滿刻度 |
FLOAT |
32 位元浮點數 | 照寫入的值保留 |
import numpy as np

hot = np.array([1.2, -1.3, 0.5], dtype=np.float32)
kudio.save_wave("hot16.wav", hot, 16000)
kudio.save_wave("hotf.wav", hot, 16000, subtype="FLOAT")
print(kudio.file_load("hot16.wav")[0])
print(kudio.file_load("hotf.wav")[0])
削峰不會有任何提示,所以凡是調過增益、混過音或降過噪的東西,寫出之前先看一下峰值,不然就先寫成 FLOAT,之後再決定。Synthesizer 會統計它不得不削峰的檔案數,就是這個原因(建立含雜訊資料集)。
每一種整數 subtype,我都在 save_wave 裡自己削峰,16-bit 輸出也自己捨入,兩件事都不交給 libsndfile。libsndfile 的削峰沒打開時,1.2 會繞回 -0.8,稍微太大聲的純音就變成一連串喀聲(下圖的虛線);soundfile 0.14 會把削峰打開,但我不想依賴特定版本。削峰打開之後,轉換是無條件捨去:經過 soundfile.write,20,000 個均勻分布的隨機樣本讀回來平均低了 0.494 個 16-bit 量化階,誤差最大到整整一階;經過 save_wave,平均誤差是 0.000,沒有任何一個超過半階。其他 PCM 寬度也用同樣的方式捨入。經過 soundfile.write 時,PCM_24 讀回來平均低三分之一階,PCM_U8 低半階,相當於滿刻度 0.004 的偏移。
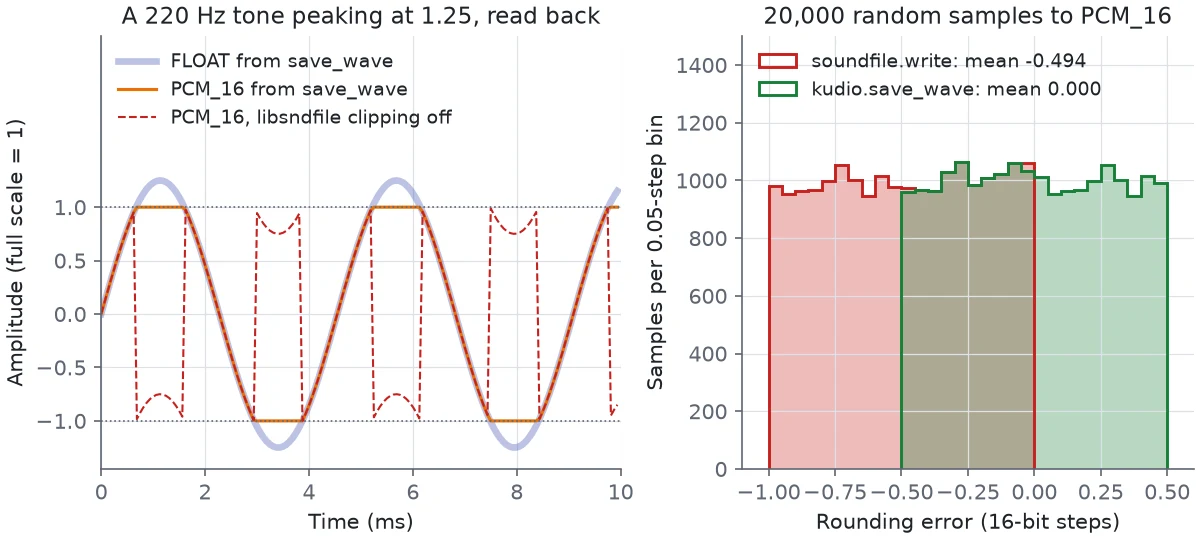
整數陣列會依它自己型別的滿刻度縮放,和 soundfile 讀回這種檔案的方式一樣:int16 乘以 1/32768,int32 乘以 1/2**31,uint8 則以中點 128 為準,在 8-bit 檔案裡 128 就是靜音。int16 陣列寫成 PCM_16 再讀回來,每個位元都不會變。
其他每個函式也用同樣的方式解讀整數陣列,所以來自 Recorder 或 scipy.io.wavfile 的 int16 陣列,量出來的結果和它的來源檔案相同,它的響度、指標或頻譜圖,也都和浮點數版本的片段一樣。如果當成單純的數字來讀,int16 片段量起來會大 90.3 dB,也就是 20 log10 32768。原本回傳 float32 的函式仍然回傳 float32;編輯函式和 normalize_lufs 則回傳和輸入相同的型別,經過捨入,並在滿刻度削峰。
NaN 和 inf
含有 NaN 或 inf 樣本的檔案還是載得進來,因為修復語料庫得先從讀取開始;同時會有一則警告寫出檔名和這種樣本的數量。之後從這個片段量出的大部分數值都會是 nan。對這種檔案或陣列,audio_info 給的峰值是 nan 並發出警告,用 math.isfinite(info.peak) 就能抓到。響度函式也會警告,audio_report 則把這些壞樣本當成唯一的問題回報(檢查錄音)。
save_wave 遇到這種樣本,會以寫出檔名的 AudioIOError 拒絕,什麼都不寫:寫成 FLOAT 會把 NaN 留給之後每個讀這個檔案的人,寫成整數 subtype 則會變成 0,讀回來就是靜音。最常見的來源,是上游某處用靜音音框算出來的增益。
在記憶體中改變取樣率
y, sr = kudio.file_load("clip.wav")
y8 = kudio.resample(y, orig_sr=sr, target_sr=8000)
same = kudio.resample(y, orig_sr=sr, target_sr=sr)
print(len(y), len(y8), same is y)                 # 56000 28000 True
resample 是 file_load(path, sr=...) 在記憶體中的對應版本,用的是同一個 soxr_hq 重新取樣器;拿 1 秒的純音測試,兩者得到的樣本完全相同。取樣率相同時,它回傳的就是你傳進去的那個陣列,而不是複本,所以可以不加判斷直接呼叫;不過如果原本的陣列還要用,就地修改結果之前請先複製一份。
(frames, channels) 陣列是沿著 frames 軸重新取樣,所以 16 kHz、1 秒的立體聲片段,重新取樣到 8 kHz 會得到 (8000, 2),save_wave(..., d_sample=) 也一樣。整數陣列回傳時維持原本的型別,捨入到最接近的值,而不是往零截斷。
蒐集檔案
lists/extra.txt 裡有一個檔案、一個空行和一個資料夾:
files, rejected = kudio.check_input(["raw/", "lists/extra.txt",
"missing.wav", "notes.flac"])
for f in files:
print(f.as_posix())
print(rejected)
raw/spk1/a.wav
raw/spk1/b.wav
raw/spk2/a.wav
corpus/dr1/fcjf0/si1027.wav

corpus/dr2/fdml0/sx133.wav
['missing.wav', 'notes.flac']
kudio 裡每個處理資料夾的工具,都是透過 check_input 讀取輸入:檔案、資料夾(不限深度搜尋)、.txt 清單,以及由這些組成的清單,要巢狀幾層都可以。它回傳找到的 .wav 檔,另外再回傳所有用不上的項目。
.txt 清單裡的相對路徑,是相對於工作目錄解析,而不是清單所在的資料夾。請以你執行程式的資料夾為基準來寫,通常就是放語料庫的那個;絕對路徑只適合一直待在同一台電腦上的清單。不論系統的字碼頁是什麼,清單都以 UTF-8 讀取,有沒有位元組順序標記(BOM)都可以,所以在一台電腦上寫好的中文檔名清單,換到另一台也讀得一樣。
判斷是不是 .wav 時不分大小寫,就像 Windows 搜尋資料夾那樣,所以錄音機產生的 ZOOM0001.WAV 在 Linux 和 macOS 上也找得到,不論是直接指名、列在清單裡,還是放在資料夾中。
load_waves 會載入 check_input 找到的所有檔案,維持原本的取樣率並轉成單聲道。加上 std_len=True 時,它會把每個波形裁到和最短的一樣長,遇到取樣率不同的檔案則拒絕:
pairs = kudio.load_waves("raw/")
print(len(pairs), pairs[0][0].shape, pairs[0][1])  # 3 (132300,) 44100
waves, sr, length = kudio.load_waves("corpus/", std_len=True)
print(len(waves), sr, length)                      # 3 16000 24000
use_pool=True 會用 core_ 個工作行程載入(預設 8 個),但只在檔案超過 300 個時才這樣做。這時在 Windows 和 macOS 上,呼叫必須放在 if __name__ == "__main__": 底下,任何 multiprocessing pool 都是這樣。check_input 拒絕的項目會被略過,並記錄一則警告;convert_folder 則把它算成失敗。
copied = kudio.copy_waves("picked/", "raw/")       # destination first
print([p.name for p in copied])                    # ['a.wav', 'b.wav', 'a2.wav']
copy_waves 的第一個參數是目的地,順序和 shutil.copy 相反,後面才接 check_input 接受的任何東西,並回傳每個檔案被複製到哪裡。順序弄反的話,copy_waves("raw/spk1/a.wav", "picked/") 會記錄目的地不是資料夾,什麼都不複製;目的地名稱裡有點的時候也一樣,例如 v1.2/。檔案依檔名直接放在目的地,不建子資料夾,檔名已被佔用時,會由 check_file 給一個沒被佔用的,所以第二位說話者的 a.wav 會變成 a2.wav。要保留結構複製整個目錄樹,請用 shutil.copytree;convert_folder 在預設設定下會混成單聲道並寫成 16-bit,所以不算複製。
轉換整個資料夾
raw/ 裡有三個 44.1 kHz 的立體聲檔案,準位各不相同。
result = kudio.convert_folder("raw/", "16k/", sr=16000, lufs=-23.0)
print(result)
for path in result.outputs:
    y, sr = kudio.file_load(path)
    print(path.as_posix(), sr, f"{kudio.loudness(y, sr):.1f} LUFS")
3/3 written, 0 failed
16k/spk1/a.wav 16000 -23.0 LUFS
16k/spk1/b.wav 16000 -23.0 LUFS
16k/spk2/a.wav 16000 -23.0 LUFS
convert_folder 對每個檔案都依序做同樣的四個步驟:
- 用
file_load載入,有給sr=就用那個取樣率,除非mono=False,否則混成單聲道; - 有設定
trim_db=時裁掉頭尾的靜音,這個值會當成top_db傳給trim_silence,mono=False的檔案,所有聲道都在同一個位置裁切; - 依
peak=或lufs=正規化; - 以
subtype=寫出,沒有另外指定就是PCM_16。
輸出會在 dst 底下照輸入的目錄樹建立,所以 spk1/a.wav 和 spk2/a.wav 仍然是兩個檔案。處理完沒剩下任何樣本的檔案,會記為失敗,而不是寫出一個空檔。輸出檔名已被佔用時,會由 check_file 給一個沒被佔用的名稱,所以第二次輸出到 16k/ 時,會在第一批旁邊寫出 16k/spk1/a2.wav 等檔案。編號前面沒有分隔符號,所以 take1.wav 會變成 take12.wav。要重做轉換,請先清空 dst,或傳入 overwrite=True。位於 src 裡面的 dst 會被排除在輸入之外,所以第二次執行不會把第一次的輸出再轉換一遍,放到更深一層的資料夾裡。
峰值還是響度
peak=0.99 會縮放每個檔案,讓最大的樣本落在 0.99,和 normalize 一樣。lufs=-23.0 則透過 normalize_lufs,縮放到依 ITU-R BS.1770 方式量測的整合響度;-23 LUFS 是 EBU R 128 的廣播目標值。要拿來聽或互相比較的檔案,我會用 lufs=,因為一個喀聲就能決定整段錄音的峰值,而峰值相同的兩個檔案,聽起來不一定一樣大聲。兩個都傳會引發 ValueError,因為第二次正規化會抵銷第一次。
響度是以 400 ms 的區塊量測,所以用 lufs= 時,短於 0.4 秒的檔案(不論是裁切前還是裁切後)會帶著 FeatureError 進到 failed;peak= 沒有最短長度的限制。數位靜音不論用哪一種都照原樣寫出。另外,響度正規化只是套用一個增益,不做別的,所以一個很安靜、卻有一個大聲暫態的檔案,可能會被推過滿刻度:normalize_lufs 會警告,預設的 PCM_16 輸出會把它削掉,所以請寫成 FLOAT,或把目標訂低一點。量測工具在檢查錄音,單獨的裁切和正規化在編輯與效果。
清單、.txt 檔和 root=
src 可以是 check_input 接受的任何東西。清單或 .txt 檔,會以其中檔案共有的最深一層資料夾為基準來建立輸出結構,所以兩位說話者念同一句 TIMIT 句子的錄音,雖然都叫 sx133.wav,也不會混在一起:
from pathlib import Path

files = sorted(Path("corpus").rglob("sx*.wav"))
result = kudio.convert_folder(files, "corpus16k/", sr=16000)
print([path.as_posix() for path in result.outputs])
全部放在同一個資料夾裡的檔案,例如同一位說話者的,共有的就是那個資料夾,所以會直接放在 dst 底下,不建子資料夾。要從更上層的資料夾開始保留結構,就把那個資料夾傳給 root=:對 corpus/dr1/fcjf0/ 裡的檔案,convert_folder(files, "corpus16k/", root="corpus") 會把它們寫到 corpus16k/dr1/fcjf0/。每個檔案都必須在 root 裡面,否則會引發 ValueError,並寫出不在裡面的那個檔案。
有檔案失敗時
result = kudio.convert_folder("incoming/", "clean/")
print(result, bool(result))
print([path.name for path, reason in result.failed])
無法讀取、裁切、正規化或寫入的檔案,不會中斷整次執行。它會以 (path, reason) 的形式放進 ConvertResult 的 failed 清單,reason 是例外的類型和訊息;只要這份清單不是空的,結果在布林判斷中就是假。改用 on_error="raise" 則會在第一個失敗時停下來。
資料夾工具看不到的東西
資料夾工具只找 .wav,其他一概不看。一整個資料夾的 FLAC 檔會引發 AudioIOError(「no audio files found」),清單裡的 .flac 則會被略過。這種目錄樹請自己寫迴圈轉進來,下面這個會保留各聲道並寫成 16-bit(24-bit 的來源請傳 subtype="PCM_24"):
from pathlib import Path

for src in sorted(Path("flac").rglob("*.flac")):
    y, sr = kudio.file_load(src, mono=False)
    dst = Path("wav") / src.relative_to("flac").with_suffix(".wav")
    kudio.save_wave(dst, y, sr)
check_input 解析不了的項目,例如不存在的路徑或清單裡的錯字,會以「not an existing .wav file」進到 failed,並算進 total,所以清單裡有一個錯字時,結果不會是「1/1 written」。
命令列用 kudio convert raw/ 16k/ --rate 16000 --recursive --lufs -23 做同樣的事,只要有任何檔案失敗就以 1 結束(命令列)。
挑一個沒被佔用的名稱
takes/ 裡已經有 rec.wav、take.wav 和 take.v2.wav。
from pathlib import Path

for name in ["new.wav", "rec.wav", "take.v2.wav", "take.flac", "take.v2"]:
    print(name, "->", Path(kudio.check_file(Path("takes") / name)).name)
print(Path(kudio.check_file("takes/take.v2.wav", sep="_")).name)
new.wav -> new.wav
rec.wav -> rec2.wav
take.v2.wav -> take.v22.wav
take.flac -> take2.wav
take.v2 -> take.v22.wav
take.v2_2.wav
check_file 回傳的一定是 .wav 檔名。屬於音訊容器的副檔名(.flac、.mp3、.ogg 等等)會被換掉,所以它沒辦法幫你找沒被佔用的 .flac 檔名。點後面的其他東西,例如 .v2 或 .2026-10-11,都算檔名的一部分,.wav 接在最後面。如果這個名稱已被佔用,會在主檔名後面加上編號,從資料夾裡現有的最大編號再往上開始,每個候選名稱回傳前都會先檢查過。檔名裡有點或數字時,用 sep="_" 可以讓編號比較好讀。
check_file 會建立上層資料夾,但不建立檔案,所以在你實際寫入之前,這個名稱並沒有被保留:請在呼叫 save_wave 前一刻才取得檔名。rename=False 會直接回傳已被佔用的名稱,並記錄一則警告。傳入資料夾時會得到 <folder>/unknown.wav,以分隔符號結尾、還不存在的路徑也一樣:newdir/ 是資料夾,newdir 則是檔名,會變成 newdir.wav。
要的是資料夾名稱,例如每次實驗一個資料夾,就用 check_path:runs/exp 和 runs/exp2 都已存在時,kudio.check_path("runs/exp") 回傳字串 runs/exp3(在 Windows 上是 runs\exp3)。它什麼都不建立,exist_ok=True 則會原封不動地回傳路徑。
由 GUI 管理的片段
AudioDataManager 是 GUI 在片段清單背後維護的登錄表:每個名稱對應到它的來源檔案、以清單形式存放的波形(每個聲道一個陣列;用 add_local_file 加入的檔案則是一個單聲道陣列)、取樣率和聲道數。在腳本裡,直接用陣列和 save_wave 比較簡單。
save_all(dst_path="session/") 會把每個片段寫進那個資料夾,名為 clip.quiet 的片段寫成 session/clip.quiet.wav。沒有 dst_path 時,它會把每個片段寫回它的來源檔案,蓋掉原檔;而 add_local_file 不管 ch 怎麼設,都只保留單聲道混音,所以立體聲的來源檔會被它的單聲道混音取代。寫入之前,save_all 會先確認沒有兩個片段會寫到同一個檔案,例如 take 和 take.wav;如果有,它會回傳 False,什麼都不寫,並在記錄裡寫出兩個名稱。沒有自己的來源檔、又沒給 dst_path 的片段,要等輪到它時才會被發現:排在它前面的片段都已經寫出,save_all 回傳 False。