房間與通道
一段錄音在變成檔案之前,會經過三種損傷,每一種背後的運算都不一樣。雜訊是加成性的:除了語音之外,還有別的聲音同時傳到麥克風,\(y + n\)。房間是摺積性的:它不加進任何東西,但會把每個聲音抹開到接下來的幾百毫秒,房間餘響持續多久就抹多久,\(y \ast h\)。第三種是錄音傳過來時經過的傳輸鏈結,kudio 的函式稱它為通道(channel)。它兩者都不是:編解碼器會量化,轉換器會丟掉位元,網路會遺失封包,這些都沒辦法寫成相加或摺積。
這一頁談房間和鏈結;混入雜訊另外有一頁,建立含雜訊資料集。範例共用同一段設定:三秒的模擬語音,兩段語句前後有停頓。要用你自己的錄音,就改用 file_load 載入,除非傳 mono=False,否則它會混成單聲道。這一頁的所有函式都只接受單聲道音訊,遇到 (frames, channels) 陣列會以 FeatureError 拒絕;如果當成一個交錯排列的訊號來讀,一個 0.6 秒響應的雙聲道複本會量出 T30 1.20 秒,擬合度 1.000。請把每個聲道分開處理。
import numpy as np
import kudio

sr = 16000
t = np.arange(3 * sr) / sr
# a 140 Hz voice with a 4 Hz syllable rhythm, silent between the phrases
voice = sum(np.sin(2 * np.pi * 140 * k * t) / k for k in range(1, 12))
y = 0.1 * voice * (0.5 + 0.5 * np.sin(2 * np.pi * 4 * t))
y[(t < 0.5) | ((t > 1.4) & (t < 1.9)) | (t > 2.6)] = 0.0
y += 0.003 * np.random.default_rng(0).standard_normal(t.size)   # a faint floor
y = y.astype(np.float32)
為什麼損傷的種類很重要
能還原其中一種損傷的工具,對其他種類不起作用。spectral_enhance 估計雜訊頻譜再把它扣掉,而房間並沒有加進任何可以扣掉的頻譜。同一個降噪器、同一段片段,用 si_sdr 評分,一次加入 5 dB SNR 的白雜訊,一次放進 0.6 秒的房間:
noise = np.random.default_rng(1).standard_normal(len(y)).astype(np.float32)
noisy = kudio.add_noise_snr(y, noise, snr_db=5, seed=0)
wet = kudio.apply_rir(y, kudio.rir(sr, rt60=0.6, drr_db=6.0, seed=0))

for name, degraded in (("noise", noisy), ("room", wet)):
    before = kudio.si_sdr(y, degraded)
    after = kudio.si_sdr(y, kudio.spectral_enhance(degraded, sr))
    print(f"{name:5} {before:4.1f} dB -> {after:4.1f} dB SI-SDR")
去除殘響是另一個問題,kudio 沒有打算處理;房間相關的函式負責產生你能控制的殘響,以及在你有脈衝響應時量測它。鏈結造成的損傷也還原不了:遺失的封包就是沒了,dropouts 能決定的只有拿什麼填那個洞。能去除的部分在降噪。
這三種損傷發生的順序永遠一樣:
房間作用在說話者身上,雜訊和房間留下的聲音一起傳到麥克風,鏈結再把麥克風收到的一切傳出去,雜訊也包括在內。建立含雜訊資料集把這條處理鏈套用到整份語料庫,並說明那裡的 SNR 是相對於什麼量的。
房間
建立房間
rir 用指數衰減的雜訊建立脈衝響應,這是擴散殘響尾巴的標準模型。rt60 是包絡衰減 60 dB 所需的時間。drr_db 是直達路徑比殘響能量高出多少,也就是用好讀的單位表示的距離:+10 dB 以上是近距離麥克風,0 左右是一兩公尺遠,大廳的另一端則是負值。長度預設是 1.5 × rt60,夠 T30 需要的 35 dB 衰減,同一個 seed 會建出同一個房間。
drr_db 是用量測時同樣的 2.5 ms 視窗反推出來的,所以在 0.3 秒以上的房間,−6 到 +20 dB 的每個值量回來都準到百分之一 dB;0.2 秒的房間在最低的幾個值可能差半個 dB,更短的房間差更多。rt60 決定包絡的斜率,在 seed=0 和預設的 drr_db 下,0.2 秒的房間量出 0.204 秒,2.0 秒的房間量出 1.994 秒。如果 drr_db 低於殘響尾巴本身已經落在視窗裡的量,會以 FeatureError 拒絕,而不是改建一個不一樣的房間。房間越短,這個下限越高:在 seed=0 下,0.2 秒是−9.2 dB,0.5 秒是 −13.3 dB,2.0 秒是 −19.4 dB。
這是統計模型的房間,沒有早期反射,也沒有牆,所以如果你研究的正是早期能量的形狀,它就不能代替實測的響應。reverb 又更粗糙,只有直達聲加上七個回聲,預設間隔 50 ms,沒有殘響時間可以指定(在編輯與效果)。資料集上需要標一個數字時,請用 rir。
把片段放進房間
apply_rir 做摺積,預設還多做兩件事。它把結果裁回輸入的長度(trim=True),因為每處理一次就變長的片段,會跟所有拿來和它比對的東西對不上。它也把峰值調回和輸入相同(normalise=True),因為直達路徑很強的房間本身帶有增益,而一個同時改變準位的資料擴增,等於一次改了兩件事。
合成房間的直達路徑就是它的第一個樣本。錄下來的響應則以聲音傳到麥克風所花的時間開頭,apply_rir 會把這段保留成延遲,而且 apply_rir 不接受取樣率。所以請以片段的取樣率載入錄下來的響應,並從直達聲的位置切開:
measured, _ = kudio.file_load("measured_ir.wav", sr=sr)   # at the clip's rate
measured = measured[np.argmax(np.abs(measured)):]         # no time of flight
wet = kudio.apply_rir(y, measured)
量測房間
rt60 回傳一個 Reverberation。T20、T30 和 EDT 都是從同一條反向積分的衰減曲線 schroeder_curve 讀出來的:分別是從 −5 降到 −25 dB、從 −5 降到 −35 dB、從 0 降到 −10 dB 所需的時間,再外推到 60 dB。這些是 ISO 3382-1 的評估範圍,T30 就是一般當作 RT60 引用的數字。C50、C80 和 DRR 是直接從響應算出來的能量比:峰值之後最初 50 或 80 ms 對上之後的全部,以及峰值前後 ±2.5 ms 對上其餘部分。fit 是 T30 擬合直線的 R²。
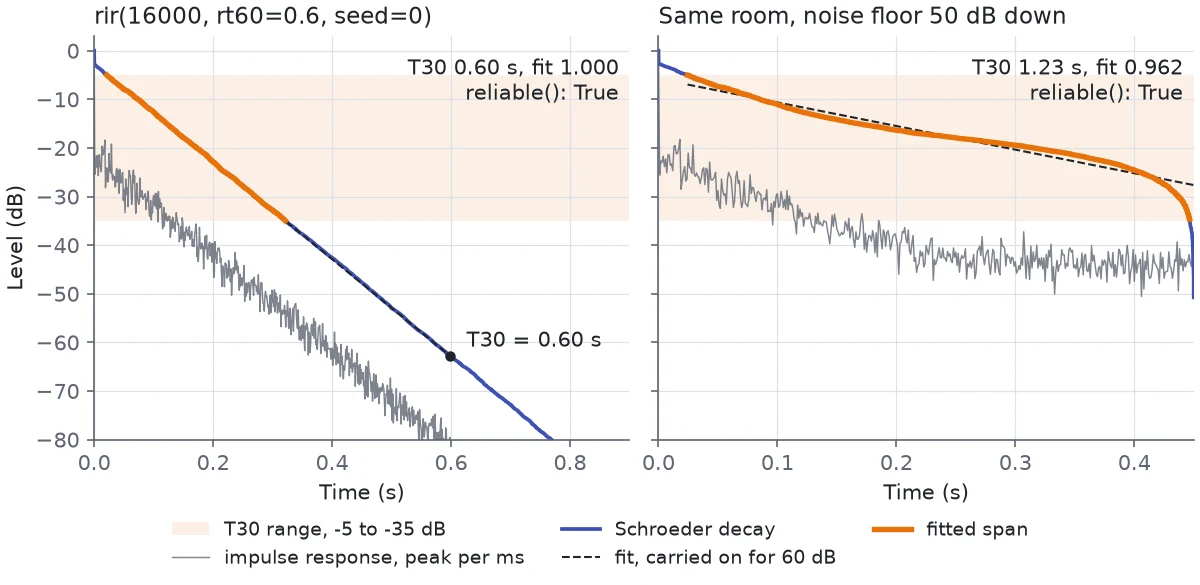
左邊是 0.6 秒的房間:從 −5 到 −35 dB,衰減是一條直線,這條線降 60 dB 所需的時間就是 T30。右邊那張屬於下面第一個警告。
先看 fit,再看其他數字。反向積分會讓任何訊號看起來都在衰減,所以 rt60 對含雜訊的語音或被截斷的響應,也會像對房間一樣照樣給出數字:
print(kudio.rt60(noisy, sr))
cut = kudio.rir(sr, rt60=1.0, seed=0)[:int(0.05 * sr)]   # 1 s room, 50 ms of it
room = kudio.rt60(cut, sr)
print(f"T30 {room.t30:.2f} s, fit {room.fit:.3f}, reliable: {room.reliable()}")
T30 2.62 s (EDT 18.47 s)  ·  C50 -11.2 dB  ·  DRR -20.3 dB  ·  fit 0.924  — but EDT and T30 disagree, so this may not be an impulse response
T30 0.19 s, fit 0.802, reliable: False
reliable() 問兩個問題。第一個是衰減是不是直線,也就是 fit 至少 0.9;被截斷的房間在這一關就沒過。含雜訊的語音卻過了,所以才有第二個問題:EDT 和 T30 是否一致。離聲源有段距離時,最初的 10 dB 和 −5 到 −35 dB 這一段描述的是同一條尾巴,所以 EDT 應該在 T30 的 MAX_EDT_RATIO(2)倍以內。這個界線是合理性檢查,不是標準裡的數字。0.6 秒、+6 dB 的房間換四十個種子,EDT/T30 都在 0.87 到 1.16 之間;含雜訊的語音則是 7。
錄下來的響應在量測前不需要先切。rt60 從起始點開始量,也就是第一個和峰值相差 20 dB 以內的樣本,所以傳播時間不會被算進衰減裡:前面加上 5 ms 的靜音,0.6 秒的房間量出來仍是 EDT 0.55 秒,也通過 reliable()。
另外,rt60 量的是給它的整個頻帶,而室內聲學報告引用這些數字時,是按八度頻帶分開列的。要算某個頻帶的數字,請用 zero_phase=False 濾波,再從峰值處切一次,因為濾波器會延遲直達聲:kudio.bandpass(ir, sr, low=355, high=710, zero_phase=False),也就是 500 Hz 的八度頻帶,對上面的房間得到 T30 0.60 秒、EDT 0.49 秒,而預設的零相位濾波器會讓 EDT 只剩 0.01 秒。結果裡只看衰減時間就好;這個 +6 dB 的房間,在這個頻帶量出來的 DRR 是 +0.1 dB。
雜訊底不會被扣掉,reliable() 也看不出來
右邊那張是同一個 0.6 秒的房間,疊在比直達聲低 50 dB 的白雜訊上。它的尾巴一開始只比雜訊底高大約 22 dB,原始響應(灰色那條)大約在 −45 dB 就不再下降,所以衰減曲線降得太慢,到切點才突然掉下去。在 0.45 秒處切,T30 會是 1.23 秒,擬合度 0.962。怎麼切都救不回來:切點從 0.15 移到 0.45 秒,得到的值從 0.39 一路到 1.23 秒,切在尾巴碰到雜訊底的地方則是 0.54 秒,而 reliable() 每次都說 True。衰減曲線在切點處一定會降過 −35 dB,所以請檢查響應本身:只有在衰減曲線穿過−35 dB 的地方,原始響應還明顯高於雜訊時,T30 才有意義。如果不是,這段錄音裡就沒有可以引用的 T30,解決辦法是用更大的準位重新量一次。
DRR 略低於 +10 dB 的麥克風,reliable() 判斷不了
靠近聲源時,最初的 10 dB 光靠直達聲就填滿了,EDT 因此變短:drr_db=9 時是 0.35 秒,而 T30 是 0.60 秒;drr_db=9.6 時是 0.04 秒,衰減明明是完美的直線,卻沒通過 EDT 的檢查。大約從 +10 dB 開始,衰減曲線在第一個樣本就降過 −10 dB,所以根本沒有 EDT。這時它回傳 NaN,摘要會寫「no EDT: the direct sound alone falls 10 dB」,reliable() 只依擬合判斷:rir(sr, rt60=0.6, drr_db=12, seed=0) 以 T30 0.60 秒、擬合度 1.000 通過。略低於 +10 dB 時,請看 fit 和 t30,判定結果先別管。
通道
電話線路
telephone 照窄頻線路的做法,依同樣的順序處理:在原本的取樣率下限頻到 300–3400 Hz(TELEPHONE_BAND),重新取樣到 8 kHz,經過 G.711 mu-law 壓擴,再轉回來。帶通濾波放在最前面,因為重新取樣器的抗混疊濾波器並不是線路的通帶。結果保留輸入時的取樣率和長度,所以在資料集裡可以和來源檔案並排放。
phone = kudio.telephone(y, sr)
print(len(phone) == len(y))
for problem in kudio.audio_report(phone, sr).problems():
    print(problem)
True
content stops at 3766 Hz although the file claims 16000 Hz — it was very likely upsampled from 8000 Hz, and the extra rate is empty
audio_report 一眼就看穿:內容在 4 kHz 以下就沒了,所以它指出這個檔案真正的取樣率是 8 kHz。它怎麼判斷,在檢查錄音有說明。
壓擴與位元深度
mu_law 和 a_law 讓訊號經過 G.711 的壓擴曲線,量化成 8 位元的碼字,再展開回來。量化階是對數的,所以量化雜訊會跟著訊號一起變小,而不是停在固定的底部。bit_depth 把同樣的 8 位元線性地分配,snr 則顯示壓擴換來了什麼:
full = y / np.max(np.abs(y))
for level in (0, -6, -12, -18, -24):
    x = (full * 10 ** (level / 20)).astype(np.float32)
    print(f"{level:3} dBFS   mu-law {kudio.snr(x, kudio.mu_law(x)):.1f}   "
          f"A-law {kudio.snr(x, kudio.a_law(x)):.1f}   "
          f"8-bit linear {kudio.snr(x, kudio.bit_depth(x, 8)):.1f}")
  0 dBFS   mu-law 37.9   A-law 38.1   8-bit linear 40.2
 -6 dBFS   mu-law 37.9   A-law 38.1   8-bit linear 34.3
-12 dBFS   mu-law 37.7   A-law 38.0   8-bit linear 28.2
-18 dBFS   mu-law 37.4   A-law 37.7   8-bit linear 22.9
-24 dBFS   mu-law 36.6   A-law 36.6   8-bit linear 18.5
準位降了 24 dB,mu-law 的 SNR 只少了 1.3 dB,線性 8 位元則少了 21.7 dB,接近「每減半少 6 dB」所預測的 24 dB。
這些是壓擴曲線本身,不是標準裡那種分段線性的區段。和 Python 的 audioop 比較(它就是 G.711 本身,在 Python 3.13 被移除了,所以不能當相依套件),在表中的各個準位下,kudio 來回一趟的 SNR 高出 0.25 到 0.83 dB,單一樣本最多相差滿刻度的百分之幾:拿來做資料擴增夠接近了,但它不是位元精確的解碼器。
滿刻度的正弦波經過 bit_depth,在 \(b\) 位元時量起來是 \(6.02\,b + 1.76\) dB:用 997 Hz 的純音,8 位元是 49.9 dB,16 位元是 98.1 dB。dither=True 會在捨入之前加上峰對峰兩個量化階寬的三角分布(TPDF)抖動,在 8 位元下會讓這個純音損失 4.7 dB:抖動本身的功率是捨入誤差的兩倍,所以雜訊變成三倍,也就是 4.8 dB。換來的是不再跟訊號相關的誤差。高度只有四分之一個量化階的正弦波,平均下來能以完整的準位回來(20 個種子平均是 1.00),沒有抖動時則什麼都不剩。請一併傳入 seed,否則每次呼叫的抖動都不一樣。
封包遺失
dropouts 把片段切成 packet_ms 長的封包(預設 20 ms,PACKET_MS,也就是 G.711 透過 RTP 傳送時用的封包長度),並遺失其中一部分。遺失的數量固定是 round(loss * packets),而不是逐個封包抽籤決定,而且是每個檔案各自捨入:在 5%時,1 秒的片段(50 個封包)會遺失 2 個,也就是 4%,0.2 秒(10 個封包)以下的片段則一個都不會遺失。return_spans=True 還會回傳每個遺失封包的位置,以秒為單位:
lossy, gaps = kudio.dropouts(y, sr, loss=0.05, seed=0, return_spans=True)
print(len(gaps), [f"{a:.2f}-{b:.2f} s" for a, b in gaps[:3]])
三秒是 150 個封包,150 的 5% 捨入後是 8,也就是 5.3%。預設的 conceal='silence' 讓洞保持空白。conceal='hold' 則在每個洞重複它前面那個封包,這是解碼器最粗糙的遺失補償。遇到一串連續遺失的封包時,它會一再重複同樣的 20 ms,而在最開頭遺失的封包會維持靜音,因為前面什麼都沒有。
波形指標選不出該用哪種補償
hold 的分數比 silence 好還是差,取決於說話者的音高和封包長度之間的關係。一個封包剛好裝得下整數個音高週期時,重複的內容相位剛好對上,結果完全相同。差十分之一個週期時,分數和留洞差不多;差三分之一到一半個週期時,相位會錯開,分數差 4 到 5 dB。以下是一段四秒的諧波音(九個諧波)遺失 10% 封包後的 kudio.snr(種子 2):
| 音高 | 每 20 ms 的週期數 | silence |
hold |
|---|---|---|---|
| 100 Hz | 2.00 | 10.0 dB | 完全相同 |
| 105 Hz | 2.10 | 10.0 dB | 9.8 dB |
| 133 Hz | 2.66 | 10.0 dB | 5.6 dB |
| 150 Hz | 3.00 | 10.0 dB | 完全相同 |
| 175 Hz | 3.50 | 10.0 dB | 5.1 dB |
用 SNR 或 SI-SDR 在兩者之間做選擇,量到的是這個巧合,而不是補償本身。每個指標實際看得到什麼,請看品質評估。
成串的遺失
預設的 burst=None 讓封包各自獨立遺失。真實的鏈結則是成串遺失(訊號衰落、佇列溢位、換手),而一整串遺失比同樣數量的零散遺失更難補償:串裡的第一個封包之後,就沒有最近的語音可以重複了,所以 hold 會在整串裡重複同一個封包。burst= 設定以封包數計的平均串長度:
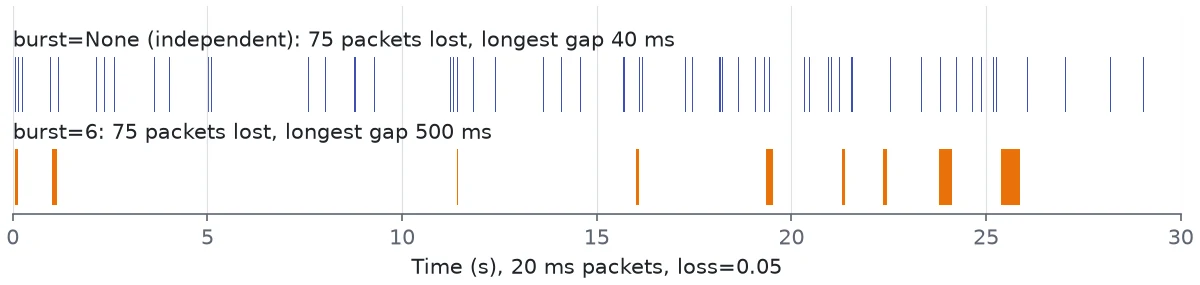
串長度呈幾何分布,就像 Gilbert 雙狀態模型裡的壞狀態;串和串之間至少隔著一個沒遺失的封包,所以兩串不會連成一串,你在輸出裡數到的串,就是抽出來的那些串。
burst=1 不是預設值換個名字而已。獨立抽取偶爾也會抽到相鄰的封包,所以預設本來就平均 1 / (1 - loss) 個封包一串,也就是 independent_burst 回傳的值:遺失 5% 時是 1.05,20% 時是 1.25。burst=1 要求每串剛好一個,聚集的程度反而比不設定時更低。把開頭設定的片段鋪成四分鐘(np.tile(y, 80)),共 12000 個封包,遺失其中 600 個,seed=0:
burst |
串數 | 平均串長 | 最長的串 |
|---|---|---|---|
None |
567 | 1.06 | 3 |
1 |
600 | 1.00 | 1 |
4 |
138 | 4.35 | 22 |
6 |
92 | 6.52 | 34 |
每一列都只抽一次,所以平均串長落在 burst 附近,而不是剛好等於它;burst=6 換 50 個種子來平均是 5.9。
一次套用整條鏈結
apply_channel 照鏈結本身的順序執行:頻帶和取樣率、編解碼器、轉換器、網路。封包是從編碼後的訊號裡遺失的,所以遺失放在最後。鏈結用一份規格描述:可以是預設組合的名稱、含有任何 CHANNEL_DEFAULTS 鍵的 dict,或是在 'preset' 鍵下指定預設組合,再加上要覆寫的設定。CHANNEL_PRESETS 裡有 telephone 和 telephone_a(頻帶加上 8 kHz 取樣率,分別用 mu-law 或 A-law)、mu_law 和 a_law(只有編解碼器,全頻帶)、voip(全頻帶 mu-law,5% 遺失、平均 4 個一串、hold),以及 none。channel_spec 會把上述任何一種形式轉成一個 dict,channel_tag 則轉成 manifest 裡記錄的標籤:{"preset": "voip", "loss": 0.1} 的標籤是 mu_law+loss10%x4-hold。
順序會反映在樣本上。如果先遺失封包,telephone 裡的帶通濾波器和兩次重新取樣,會把兩側的語音抹進每一個洞:
right = kudio.apply_channel(y, sr, {"preset": "telephone", "loss": 0.1}, seed=0)
wrong = kudio.telephone(kudio.dropouts(y, sr, loss=0.1, seed=0), sr)
print(np.count_nonzero(right == 0.0), np.count_nonzero(wrong == 0.0))
順序正確時,遺失的 15 個封包是 4800 個完全靜音的樣本,每個封包 320 個;順序錯誤時,沒有一個樣本是零。
channel_spec 會拒絕未知的設定、編解碼器或補償方式、0 到 1 以外的遺失比例、少於 2 的位元數、小於 1 的 burst,以及零或負的 packet_ms。apply_channel 和 Synthesizer 會在任何音訊通過之前先呼叫它,所以給了錯誤鏈結的 Synthesizer 在建立時就會失敗,不會等到第一個檔案。規格裡的 band 只有開或關;要用其他邊界頻率,請自己呼叫 telephone(..., band=)。
一段片段的完整流程,依序是房間、雜訊和鏈結:
wet = kudio.apply_rir(y, kudio.rir(sr, rt60=0.5, drr_db=3.0, seed=0))
mix = kudio.add_noise_snr(wet, noise, snr_db=10, seed=0)
out = kudio.apply_channel(mix, sr, "voip", seed=0)
Synthesizer 以 channel= 接受同樣的規格,套用到每一份完成的混音上;建立含雜訊資料集說明了每個檔案的種子怎麼決定、manifest 裡的標籤,以及為什麼鏈結不是要掃過的軸。
從命令列使用
kudio room 量測一個響應,reliable() 為 False 時以 1 結束。--make 建立一個房間,--apply 則讓檔案通過一個由 --rt60、--drr 和 --seed 建立的合成房間;錄下來的響應要在 Python 裡透過 apply_rir 套用。kudio channel 劣化一個檔案,並回報它做了什麼,包括遺失了哪幾串。