降噪
kudio.enhance 是單聲道的統計式降噪:不用模型、不用訓練資料,也沒有東西要下載。它先估計雜訊,算出每個時頻格裡有多少語音,再依此把每個時頻格調小。七種增益規則和四種雜訊估計器共用同一個 STFT 迴圈,所以任何規則都能搭配任何估計器,其中四種規則也能在即時串流上執行。
| 你手上有 | 用這個 |
|---|---|
| 一段含雜訊的片段 | spectral_enhance |
| 一段片段,想知道哪種方法適合它 | compare_enhancers |
| 還在持續進來的音訊 | StreamEnhancer |
| 一整個資料夾的錄音 | enhance_folder |
範例使用的片段
16 kHz、五秒長:兩段由諧波構成的「人聲」,前、中、後都有停頓,再用 add_noise_snr 以 5 dB SNR 混入白雜訊。這個 SNR 是對整段片段算的,包含停頓;人聲出聲的時候是 7.0 dB。亂數有設種子,所以在這個區塊之後執行下面的區塊,印出來的會和頁面上一樣。
import numpy as np

import kudio

sr = 16000
t = np.arange(sr * 5) / sr
rng = np.random.default_rng(0)

def voice(start, stop, f0):
    """Thirteen harmonics of f0, rising and falling 3.5 times a second."""
    span = (t >= start) & (t < stop)
    tone = sum(np.sin(2 * np.pi * f0 * k * t) / k for k in range(1, 14))
    swell = 0.5 + 0.5 * np.sin(2 * np.pi * 3.5 * t)
    return np.where(span, tone * swell / 7, 0.0)

clean = (voice(0.5, 2.0, 140) + voice(2.8, 4.5, 170)).astype(np.float32)
noisy = kudio.add_noise_snr(clean, rng.standard_normal(len(clean)),
                            snr_db=5, seed=0)
一次呼叫
enhanced = kudio.spectral_enhance(noisy, sr)   # log-MMSE, MCRA noise estimate
before, after = kudio.si_sdr(clean, noisy), kudio.si_sdr(clean, enhanced)
print(f"SI-SDR {before:.2f} dB -> {after:.2f} dB")
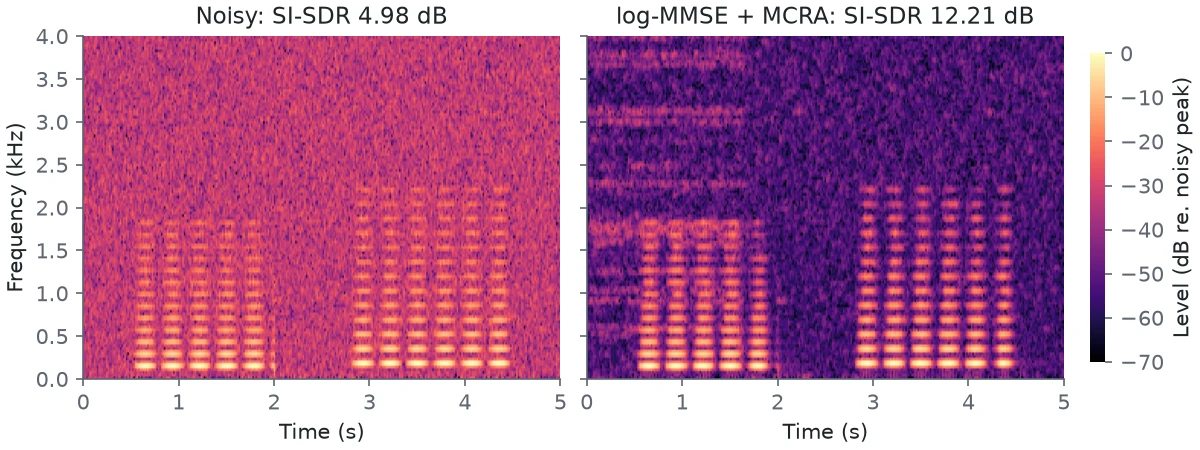
前兩秒那些條紋,是 MCRA 的雜訊估計還沒穩定下來造成的;原因在四種雜訊估計器。
輸出是 float32,和輸入一樣長,而且逐樣本對齊,所以可以直接拿去算指標或做 A/B 比較。音訊必須是單聲道,比一個音框還短的片段(除非傳了 n_fft=,否則是 512 個樣本)會被拒絕,而不是補零。方法自己的參數以關鍵字參數傳入,傳了它不接受的參數就是錯誤:
先估計雜訊,再算增益
對每個 STFT 音框 \(l\) 和頻率格 \(k\),每種方法都用四種估計器之一(noise=)估計雜訊功率 \(\lambda_d(k,l)\),再換算成介於下限和 1 之間的增益,乘上複數頻譜,含雜訊的相位則保持不動。wiener、mmse_stsa、logmmse 和 omlsa 在中間多做一步:用 Ephraim 和 Malah4 的決策導向法,估計先驗訊雜比 \(\xi(k,l)\),也就是這個時頻格裡有多少語音。這四種的差別,只在之後用的增益函數:
\(\hat S(k,l-1)\) 是前一個音框的語音估計。在 \(\alpha = 0.98\) 時,估計幾乎完全倚賴它,這能壓低音樂雜訊,但也讓這四種方法在語音剛出現時,增益放開得比較慢。\(\gamma\) 的上限是 40 dB,否則一個很大聲的音框,就能把估計拖到一個要好幾秒才離得開的地方;\(\xi\) 的下限則是 −25 dB。specsub、multiband 和 spectral_gate 則是從雜訊估計直接算出增益。
我把估計器和增益規則分開,這樣就能固定其中一個,只改變另一個。在這段片段上,同一個估計器下的七種規則,SI-SDR 最高和最低平均相差 5.7 dB;同一種規則下的四種估計器,則相差 7.5 dB。哪一個影響比較大,要看錄音而定,所以 compare_enhancers 兩者都能掃過。
七種增益規則
| 方法 | 做法 | 選它的理由 | 它自己的參數 |
|---|---|---|---|
specsub |
減去雜訊功率的某個倍數:Boll 的方法1,加上 Berouti 的過減和下限2 | 最省運算;「音樂雜訊」這個說法就是從它來的 | over_subtraction 2.0、spectral_floor 0.002 |
multiband |
每個頻帶各用一個減法因子:頻帶 SNR 低於 −5 dB 時是 4.75,逐漸降到 20 dB 以上時的 1.03 | 有色雜訊不是在每個頻帶都一樣大聲 | bands 6、spectral_floor 0.002 |
wiener |
增益 \(\xi/(1+\xi)\) | 平滑,所以音樂雜訊少;低 SNR 時聲音會變悶 | alpha 0.98 |
mmse_stsa |
振幅的 MMSE 估計4 | 比 Wiener 保留更多語音 | alpha 0.98 |
logmmse |
在對數振幅域做 MMSE5 | 它是預設;在這段片段上搭配 MCRA,和最好的規則相差在 0.05 dB 以內 | alpha 0.98 |
omlsa |
以語音存在機率加權的 log-MMSE6 | 判定沒有語音的頻率格,會壓到增益下限,所以這裡的停頓比 log-MMSE 的安靜大約 3 dB;q 決定一個頻率格多容易被當成空的 |
alpha 0.98、q 0.30 |
spectral_gate |
頻率格高出雜訊估計的量,超過雜訊估計隨時間的分散程度(以 dB 計)的 n_std_thresh 倍,就保留下來,透過平滑過的遮罩套用 |
單純的門檻,和 noisereduce 的做法一樣。在這一頁的白雜訊上,不論搭配哪個估計器都排最後,而且把語音連同雜訊一起調小了 5 dB | n_std_thresh 1.5、prop_decrease 1.0、freq_smooth_hz 500、time_smooth_ms 50 |
固定不動的雜訊估計幾乎沒有隨時間的分散程度:quantile 完全沒有,initial 只在它取平均的開頭那幾個音框有一點,所以搭配這兩個時,spectral_gate 的門檻就落在估計值上,或只比它高一點點。其他所有方法都還接受 gain_floor_db,預設 −25 dB:任何頻率格最多能被調小多少。完全歸零是錯誤的目標,因為殘留雜訊之所以聽起來忽高忽低地顫動,正是完全抑制造成的。在相同的 \(\xi\) 和 \(\gamma\) 下,Wiener 把頻率格壓得最多,MMSE-STSA 壓得最少,log-MMSE 介於兩者之間;在高 SNR 時,MMSE-STSA 的結果和 Wiener 相同。測試套件兩件事都有檢查。
METHODS 把這些全部存成資料。每一項都是一個 Method,它的每個 Param 都帶有預設值、範圍、步進、單位和一句說明,足以讓 GUI 或命令列直接建立控制項,不必再另外寫一遍:
q = {p.name: p for p in kudio.METHODS["omlsa"].params}["q"]
print(q.default, q.low, q.high, q.step)
print(q.help)
0.3 0.01 0.95 0.05
A priori probability that a bin holds no speech. Higher suppresses more and risks clipping onsets.
四種雜訊估計器
| 估計器 | 假設 | noise_kwargs 與預設值 |
可串流 |
|---|---|---|---|
mcra |
雜訊是每個頻率格功率的遞迴平均;頻率格高出它一路追蹤的最小值 5 倍以上時就停住不更新,因為那裡多半有語音7 | window=100 個音框、delta=5(另有 ass、ad、ap) |
是 |
quantile |
雜訊是每個頻率格在整個檔案上的某個低分位數,再放大到穩態雜訊的平均值 | quantile=0.15 |
否 |
initial |
開頭的幾個音框只有雜訊;之後一直沿用它們的平均 | n_frames=6 |
是 |
minimum |
雜訊是平滑後頻譜在滑動視窗內的最小值,乘上一個固定的偏差係數 | window=60、bias=1.5、smoothing=0.85 |
是 |
預設是 mcra。NOISE_ESTIMATORS 對每一種都有一句說明;在這段片段上,選哪個估計器對結果的影響比增益規則還大:
print(kudio.NOISE_ESTIMATORS["initial"])
for noise in kudio.NOISE_ESTIMATORS:
    out = kudio.spectral_enhance(noisy, sr, "logmmse", noise=noise)
    print(f"{noise:9} {kudio.si_sdr(clean, out):.2f} dB")
Average of the first few frames, assumed to be room tone. Exact when that is true and badly wrong when it is not.
mcra      12.21 dB
quantile  14.16 dB
initial   14.86 dB
minimum   6.86 dB
initial 在這裡勝出,因為片段開頭是半秒只有雜訊、沒有別的聲音,完全符合它的假設。在 16 kHz、預設的音框設定下,它的六個音框涵蓋片段開頭的 56 ms。不管取樣率多少,音框都是 512 個樣本,所以在 48 kHz 時,同樣六個音框只涵蓋 19 ms;環境音比較長時,請調高 n_frames。
上圖那些條紋,原因出在 mcra。它的估計值和一路追蹤的最小值都從第一個音框開始,而離線的 STFT 是置中的,所以那個音框有一半是補零:這裡有三分之一的頻率格,起始值比雜訊低了 7 dB 以上。這樣的頻率格看起來像語音,所以估計值停住不動,一直偏低,直到最小值搜尋跑完兩個 100 音框長的視窗為止,在 16 kHz 是 1.6 秒。開頭半秒留下的殘留雜訊,比 2.0–2.8 秒那段停頓多大約 10 dB(−38.5 對 −48.1 dBFS)。如果錄音一開頭有幾秒環境音,這段在有人開口之前就過去了。
quantile 取每個頻率格在整個檔案上的第 15 百分位數,再把它放大。一個頻率格裡穩態雜訊的功率呈指數分布,所以它的 q 分位數只有平均值的 \(-\ln(1-q)\) 倍,在預設值下低了 7.9 dB,估計值就再除以這個倍數。它不必對檔案的開頭做任何假設,在這裡和 initial 相差在 0.7 dB 以內。分位數必須低於檔案中該頻率格沒有語音的時間比例:設成 noise_kwargs={"quantile": 0.5} 時,語音會混進統計量裡,這段片段就掉到 12.87 dB。noise_kwargs 是傳給估計器的,它不接受的鍵會以 FeatureError 拒絕,訊息裡會列出它接受的鍵。
要自己寫迴圈時,estimate_noise_psd 可以在 (frames, bins) 的功率頻譜圖上執行任何估計器,make_noise_tracker 則把 quantile 以外的每一種,做成「狀態加上一次一個音框的更新」。DecisionDirected 對先驗訊雜比做同樣的事,make_gain_rule 則回傳四種決策導向規則之一的增益函數,不含下限:請像 spectral_enhance 那樣,把它的輸出截在 [10 ** (gain_floor_db / 20), 1] 之間。離線和串流兩條路徑都是由這些物件組成的,所以每一條更新規則都一樣。
挑選方法
compare_enhancers 對同一段片段執行好幾種方法,並分別量測。一次執行就是一組(方法,估計器):methods= 選規則(省略時是全部七種),noises= 掃過估計器,兩者一起用就是完整的網格。
results = kudio.compare_enhancers(noisy, sr, reference=clean,
                                  noises=list(kudio.NOISE_ESTIMATORS),
                                  metrics=False)
ranked = sorted((r for r in results if not r.error),
                key=lambda r: r.si_sdr_db, reverse=True)
print(len(ranked))
for r in ranked[:4]:
    print(f"{r.label:20} SI-SDR {r.si_sdr_db:+.2f} dB",
          f"  dSNR {r.delta_snr_db:+.2f} dB")
28
wiener + initial     SI-SDR +15.37 dB   dSNR +10.48 dB
omlsa + initial      SI-SDR +15.26 dB   dSNR +10.36 dB
logmmse + initial    SI-SDR +14.86 dB   dSNR +10.00 dB
multiband + quantile SI-SDR +14.52 dB   dSNR +9.65 dB
每一列是一個 EnhanceResult,包含執行時間、雜訊底和響度。有 reference= 時還會有 SNR、SI-SDR 和 delta_snr_db;在預設的 metrics=True 下,如果有安裝 kudio[pesq] 和 kudio[eval],還會有 PESQ 和 STOI(PESQ 只在 8 和 16 kHz 時計算)。比較所花的時間大多花在這兩個指標上:在我的電腦上,上面 28 次執行算 STOI 時花 2.0 秒,不算則是 1.0 秒。引發例外的執行會以一列回傳,error 有值,雜訊底和響度是 NaN,分數是 None,所以排序之前要像上面那樣先濾掉。計時從一次暖機執行之後才開始,所以第一個方法不會被算進 librosa 的 JIT 編譯時間。
delta_snr_db 是輸出的 SNR 減掉未處理輸入的 SNR,兩者都是對參考訊號算的:這個數字回答的是「到底有沒有幫助」。它是單純的 SNR,所以連語音也一起調小的方法會因此被扣分,SI-SDR 則不管準位。兩者講的可能是不同的故事。在同樣的 28 次執行裡,spectral_gate + mcra 的 SI-SDR 增加了 3.15 dB(4.98 到 8.13),SNR 卻只增加 1.16 dB,因為它把語音連同雜訊一起調小了 5 dB。pesq_mode= 和 pesq_scale= 是傳給 PESQ 的;論文指的是哪一種尺度,品質評估有說明。
其他關鍵字參數會傳給接受它們的執行,其餘的執行則不傳,這和 spectral_enhance 剛好相反:q=0.9 只會傳到 omlsa,所以它可以和六個沒有 q 的方法放在同一個呼叫裡,而 n_fft= 和 noise_kwargs= 則會傳到每一次執行。呼叫中沒有任何方法接受的關鍵字參數,就是打錯字,會在任何東西開始執行之前就被拒絕;只有其中一個被掃過的估計器接受的 noise_kwargs 鍵,會讓其他估計器的執行失敗。noise="initial" 是固定估計器,而不是掃過它;和 noises= 一起給會被拒絕。
沒有參考訊號時(真實錄音通常就是這樣),你拿到的是雜訊底(30 ms 音框準位的第 10 百分位數,和檢查錄音裡 audio_report 的量法相同)和響度:
for r in kudio.compare_enhancers(noisy, sr, ["wiener", "logmmse", "omlsa"]):
    print(f"{r.label:16} floor {r.noise_floor_db:.1f} dBFS   {r.lufs:.1f} LUFS")
wiener + mcra    floor -53.6 dBFS   -24.4 LUFS
logmmse + mcra   floor -48.6 dBFS   -24.3 LUFS
omlsa + mcra     floor -51.2 dBFS   -24.5 LUFS
雜訊底最低,不代表結果最好:wiener 在這裡留下的雜訊最少,對參考訊號評分時卻還是比 logmmse 低,11.84 對 12.21 dB。這兩欄都看不出語音變成什麼樣子,所以在相信最小的那個數字之前,先聽聽看。
把自己的降噪器拿來排名
訓練好的模型、包裝其他函式庫的程式,或是一次性的實驗,都可以放進同一張表:傳入一個吃 (y, sr)、回傳增強後波形的函式,直接傳或包成 (name, function) 都可以。
def lowpassed(y, sr):
    return kudio.lowpass(kudio.spectral_enhance(y, sr), sr, 4000)

for r in kudio.compare_enhancers(noisy, sr, ["logmmse", kudio.trad_enhance,
                                             ("lowpassed", lowpassed)],
                                 reference=clean, metrics=False):
    print(f"{r.label:20} SI-SDR {r.si_sdr_db:+.2f} dB")
logmmse + mcra       SI-SDR +12.21 dB
trad_enhance + own   SI-SDR +14.09 dB
lowpassed + own      SI-SDR +13.08 dB
直接傳入的函式以它自己的名字命名,估計器那一欄寫的是 own(CUSTOM_NOISE):它自己處理雜訊,所以就算 noises= 掃過內建的估計器,它也只執行一次。CustomEnhancer 是同樣的項目,只是寫成物件。用 KudioEnhance 訓練的模型也用同樣的方式放進來,寫成 ("model", Enhancer.load(run_dir).enhance),其中 Enhancer 來自 kudioenhance.inference。參考型指標比較的是兩個訊號都有的樣本,所以輸出稍微短一點沒問題,有延遲的就不行:請先對齊,做法在品質評估。
幫不上忙的地方
兩個限制,以上面的人聲實測
這些方法是給含雜訊的音訊用的。每一種都是以語音失真為代價來去除雜訊,輸入越乾淨,這筆交易就越不划算。下面是搭配 MCRA 時的 delta_snr_db(單位 dB),白雜訊以各個輸入 SNR 混進乾淨的人聲:
| 輸入 SNR | 最佳 | 其他六種中最差 | spectral_gate |
|---|---|---|---|
| −5 dB | +10.5 | +6.9 | +6.5 |
| 0 dB | +9.0 | +6.5 | +3.9 |
| 5 dB | +7.6 | +6.0 | +0.4 |
| 10 dB | +5.9 | +4.3 | −4.6 |
| 15 dB | +3.1 | +0.5 | −9.9 |
| 20 dB | −0.1 | −4.0 | −15.0 |
spectral_gate 從 10 dB 開始就掉到零以下。其他六種到 15 dB 都還有增益,到了 20 dB,七種都讓片段變得比原來更差。這就是每個 EnhanceResult 都帶著 delta_snr_db 的原因。
它們需要單獨聽到雜訊。MCRA 是在字與字之間的空檔學雜訊。同樣的人聲如果一段緊接一段、中間沒有停頓,它幾乎沒有東西可學,initial 這時則會把語音平均起來,當成雜訊。前面先有一秒環境音,正是 initial 派得上用場的情況:
logmmse 的 delta_snr_db,輸入 SNR 5 dB |
mcra |
initial |
|---|---|---|
| 有停頓 | +7.6 | +9.4 |
| 沒有停頓 | +1.3 | −2.4 |
| 沒有停頓,前面先有一秒環境音 | +3.7 | +8.7 |
這兩張表是怎麼量的
noise = np.random.default_rng(1).standard_normal(len(clean))
for snr_in in (-5, 0, 5, 10, 15, 20):
    mixed = kudio.add_noise_snr(clean, noise, snr_db=snr_in, seed=0)
    runs = kudio.compare_enhancers(mixed, sr, reference=clean,
                                   metrics=False)
    delta = {r.method: r.delta_snr_db for r in runs}
    gate = delta.pop("spectral_gate")
    print(f"{snr_in:+3d} dB  best {max(delta.values()):+5.1f}",
          f" worst of six {min(delta.values()):+5.1f}  gate {gate:+5.1f}")

steady = (voice(0.0, 2.5, 140) + voice(2.5, 5.0, 170)).astype(np.float32)
lead_in = np.concatenate([np.zeros(sr, np.float32), steady])
cases = {"pauses": clean, "no pauses": steady, "room tone": lead_in}
for name, signal in cases.items():
    hiss = np.random.default_rng(1).standard_normal(len(signal))
    mixed = kudio.add_noise_snr(signal, hiss, snr_db=5, seed=0)
    deltas = [kudio.compare_enhancers(mixed, sr, ["logmmse"], noise=est,
                                      reference=signal,
                                      metrics=False)[0].delta_snr_db
              for est in ("mcra", "initial")]
    print(f"{name:10} mcra {deltas[0]:+.1f}  initial {deltas[1]:+.1f}")
 -5 dB  best +10.5  worst of six  +6.9  gate  +6.5
 +0 dB  best  +9.0  worst of six  +6.5  gate  +3.9
 +5 dB  best  +7.6  worst of six  +6.0  gate  +0.4
+10 dB  best  +5.9  worst of six  +4.3  gate  -4.6
+15 dB  best  +3.1  worst of six  +0.5  gate  -9.9
+20 dB  best  -0.1  worst of six  -4.0  gate -15.0
pauses     mcra +7.6  initial +9.4
no pauses  mcra +1.3  initial -2.4
room tone  mcra +3.7  initial +8.7
還在進來的音訊
StreamEnhancer 一次一個區塊執行同樣的更新,所以錄音的同時,就能透過降噪器監聽。區塊可以是任何大小:process 回傳已經處理完的音訊,沒有更多輸入之後,再用 flush 取得剩下的部分。
enhancer = kudio.StreamEnhancer(sr, "logmmse")
print(f"latency {enhancer.latency_seconds * 1000:.0f} ms")

pieces = [enhancer.process(noisy[i:i + 1024])       # one 64 ms block at a time
          for i in range(0, len(noisy), 1024)]
pieces.append(enhancer.flush())
streamed = np.concatenate(pieces)
print(len(noisy), len(streamed))
print(f"streamed {kudio.si_sdr(clean, streamed):.2f} dB,",
      f"offline {kudio.si_sdr(clean, enhanced):.2f} dB")
延遲是一個分析音框,n_fft / sr:一整個音框到齊之前什麼都不會輸出,之後輸出會以一次一個位移長度的小段跟上。這是等待,不是時間偏移,所以把所有輸出接起來之後,第 i 個樣本和輸入的第 i 個樣本對齊。flush() 會把最後不完整的音框補零,讓尾端也被處理而不是被丟掉,並在輸入結束的地方停下,所以整段輸出和輸入一樣長。測試套件把同一段音訊切成 1、7、128、512、1024 和 9999 個樣本的區塊餵進去,得到的輸出相差在 10⁻⁶ 以內。reset 會清掉所有緩衝區和估計值,準備錄下一段。
串流和離線的輸出很接近,但不完全相同。串流的第一個音框是完整的,離線 STFT 的第一個音框則有一半是補零;搭配 mcra 時,這個開頭對串流有利:這段片段換十組雜訊抽樣,串流的 SI-SDR 每次都領先 0.8 到 1.6 dB。搭配 initial 和 minimum 時,兩者相差在 0.7 dB 以內。
能串流的是 STREAMABLE_METHODS 裡的四種方法:wiener、mmse_stsa、logmmse 和 omlsa,搭配 mcra、initial 或 minimum。spectral_gate 不行:它的門檻是根據雜訊估計在整個檔案上的分散程度決定的,遮罩也在時間上往前、往後兩個方向做平滑。quantile 也不行,它是整個檔案的統計量。這兩者的串流版本,都會是頂著同一個名字的另一種演算法。specsub 和 multiband 只需要目前的音框,但 StreamEnhancer 只跑決策導向的迴圈,其他什麼都不跑,所以不接受它們。要求這三種中的任何一種,都會得到 FeatureError,訊息會列出能串流的四種,並給出用 spectral_enhance 離線執行該方法的呼叫。
從麥克風輸入時,請餵它 StreamRecorder.drain(),絕對不要用 tail():tail() 給出的是互相重疊的視窗,同一段樣本看到兩次,會破壞降噪器裡的每一個遞迴估計。錄音器請維持單聲道:process() 會以 FeatureError 拒絕雙聲道的區塊。迴圈的寫法在錄音與即時檢視。
整個資料夾
enhance_folder 把一個資料夾底下的每個 .wav 檔降噪後寫到另一個資料夾,並像 convert_folder 一樣照子資料夾的結構排列,所以不同資料夾裡同名的兩段錄音不會撞名:
hiss = np.random.default_rng(1).standard_normal(len(clean))
for name, snr_db in [("day1/take1.wav", 0), ("day1/take2.wav", 5),
                     ("day2/take1.wav", 10)]:
    kudio.save_wave(f"noisy/{name}",
                    kudio.add_noise_snr(clean, hiss, snr_db=snr_db, seed=0), sr)

result = kudio.enhance_folder("noisy", "enhanced", "logmmse", report=True)
print(result)
for path, before, after in result.floors:
    print(f"{path.as_posix()}: floor {before:.1f} -> {after:.1f} dBFS")
print(f"{result.mean_reduction_db():.1f} dB down on average")
3/3 written, 0 failed
enhanced/day1/take1.wav: floor -24.4 -> -43.5 dBFS
enhanced/day1/take2.wav: floor -29.4 -> -48.4 dBFS
enhanced/day2/take1.wav: floor -34.4 -> -53.3 dBFS
19.0 dB down on average
回傳的是 EnhanceFolderResult:一個 ConvertResult(只要有任何檔案失敗,放在 if 裡就是 false),再加上 report=True 量到的 floors。參數只在處理第一個檔案之前檢查一次,所以打錯字只會得到一個錯誤,而不是每個檔案各失敗一次。noise=、n_fft=、hop_length=、window= 和 noise_kwargs= 會像單次呼叫時那樣傳給 spectral_enhance,方法也可以是 compare_enhancers 接受的任何東西,包括訓練好的模型。清單或 .txt 檔案清單,會以其中檔案共同所在最深的資料夾為起點排列,和 convert_folder 的做法一樣。每個檔案都以單聲道載入、寫成 16-bit PCM;sr=、subtype=、on_error=、progress= 和 overwrite= 請看 API 參考。對同一個資料夾再執行一次時,會保留原有的檔案,把新的 day1/take1.wav 寫成 day1/take12.wav,除非 overwrite=True。
兩個固定做法
trad_enhance 是一套固定做法,取自 Loizou 的 Speech Enhancement: Theory and Practice:512 個樣本、套 Hamming 窗的音框,50% 重疊,MCRA 雜訊估計,功率頻譜相減,過減因子依每個音框的 SNR 設定,最後是 Wiener 式的增益。沒有任何東西可以調整或掃過,而在這段片段上表現不錯:
out = kudio.trad_enhance(noisy, sr)
print(len(noisy), len(out), out.dtype)
print(f"{kudio.si_sdr(clean, out):.2f} dB")
輸出和輸入一樣長。它的音框每次位移 256 個樣本,所以比這還短的尾端沒有自己的音框,回傳時是靜音:這裡是最後 128 個樣本,8 ms。比一個 512 樣本音框還短的片段,會以 FeatureError 拒絕,因為回傳的會是一段靜音。
wavelet_low_pass_filter 對完整 db2 分解的細節係數做軟門檻處理,每一層都用同一個門檻:thres 乘上片段的峰值 max |y|。最細的幾層會先被削掉,所以它的作用像低通濾波器,在預設的 thres=0.8 下還是很重的低通:在這段片段上,人聲本身在 1 kHz 以下少了 7.6 dB,SI-SDR 從 4.98 掉到 4.00 dB(thres=0.1 時是 11.20 dB)。輸出和輸入一樣長,靜音的片段則原樣回傳。如果要的只是單純的截止頻率,請用編輯與效果裡的 Butterworth 濾波器。
從命令列
kudio enhance 對一個檔案執行 spectral_enhance,kudio compare 則執行 compare_enhancers,有參考訊號時,最好的排在最前面:
kudio enhance in.wav out.wav --method omlsa --noise mcra --set q=0.4
kudio compare in.wav --reference clean.wav
kudio compare in.wav --reference clean.wav --noises all   # the full grid
所有選項都列在命令列。
-
S. F. Boll, "Suppression of acoustic noise in speech using spectral subtraction", IEEE Trans. Acoust., Speech, Signal Process. 27(2), 1979. ↩
-
M. Berouti, R. Schwartz and J. Makhoul, "Enhancement of speech corrupted by acoustic noise", ICASSP 1979. ↩
-
S. Kamath and P. Loizou, "A multi-band spectral subtraction method for enhancing speech corrupted by colored noise", ICASSP 2002. ↩
-
Y. Ephraim and D. Malah, "Speech enhancement using a minimum mean-square error short-time spectral amplitude estimator", IEEE Trans. Acoust., Speech, Signal Process. 32(6), 1984. ↩↩
-
Y. Ephraim and D. Malah, "Speech enhancement using a minimum mean-square error log-spectral amplitude estimator", IEEE Trans. Acoust., Speech, Signal Process. 33(2), 1985. ↩
-
I. Cohen and B. Berdugo, "Speech enhancement for non-stationary noise environments", Signal Processing 81(11), 2001. ↩
-
I. Cohen and B. Berdugo, "Noise estimation by minima controlled recursive averaging for robust speech enhancement", IEEE Signal Process. Lett. 9(1), 2002. ↩