STFT 與特徵
模型從 kudio 拿到的東西,大多是每個音框一列的矩陣,不管是對數功率頻譜圖、MFCC,還是堆疊起來的對數梅爾向量。這些東西最常出錯的地方是形狀,所以下面每一節都會寫清楚回傳的是什麼。
| 要做的事 | 用這個 |
|---|---|
| 取得對數功率頻譜圖,並把它的設定和模型存在一起 | STFT,只用一次的話用 waveform_to_spectrogram |
| 為分類器取得精簡的特徵 | melspectrogram、mfcc |
| 讓每一列帶上前後相鄰的音框,或切出固定長度的視窗 | stack_context、ContextFrames、frame_windows |
| 用訓練集的統計量縮放特徵 | Standardizer |
| 把預測出來的頻譜圖轉回音訊 | STFT.inverse、save_spectrogram_as_wave |
| 套用複數遮罩或增益 | STFT.analyse 和 STFT.synthesise |
| 對一串檔案計算對數頻譜圖或 MFCC | logspec_from_files、mfcc_from_files |
| 標出哪些音框有語音 | vad_frames,在語音活動與音高 |
這些函式都是對整段片段做運算。要在音訊還在進來時畫頻譜圖,請用 SpectrogramStream(錄音與即時檢視)。它每一欄切音框的方式不同(Hann 窗、位移 n_fft // 4、不置中),存的也是 dB 而不是貝爾,所以用這一頁的列訓練出來的模型,不該拿它的欄當輸入。
範例在同一段 16 kHz、兩秒長的片段上依序執行,後面的區塊會用到前面建立的名稱(stft、spec、windows、std)。你可以用 file_load 載入自己的錄音,或者用雜訊跟著做:
import numpy as np
import kudio

sr = 16000
y = (0.1 * np.random.default_rng(0).standard_normal(2 * sr)).astype(np.float32)
列就是音框
librosa 回傳的是 (bins, frames)。這一頁的每個函式都回傳 (frames, bins),時間在前:一列是訊號的一個時刻,音框分類器把它當成一筆樣本,序列模型則是一列一列往下走。只有交給頻率在前的程式碼時才需要轉置:讓頻率往上畫的 plt.imshow(spec.T, origin="lower", aspect="auto")、librosa.display.specshow(spec.T),以及 kudio 自己的 spec_augment,它的呼叫方式和遮罩值在編輯與效果。
對上面那段片段,其他參數都用預設值(spec 是第一列的結果):
| 呼叫 | 形狀 | 這段片段 | 數值 |
|---|---|---|---|
kudio.waveform_to_spectrogram(y) |
(frames, n_fft // 2 + 1) |
(126, 257) |
log10 功率,float32 |
kudio.STFT().analyse(y) |
(frames, bins) |
(126, 257) |
complex64 |
kudio.mfcc(y, sr) |
(1, mel_frames, n_mfcc) |
(1, 63, 40) |
float32 |
kudio.melspectrogram(y, sr=sr) |
(mel_frames - n_frames + 1, n_mels * n_frames) |
(59, 320) |
dB,float32 |
kudio.melspectrogram(y, sr=sr, n_frames=1) |
(mel_frames, n_mels) |
(63, 64) |
dB,float32 |
kudio.stack_context(spec, 2) |
(frames, bins * 5) |
(126, 1285) |
邊緣填補,float32 |
kudio.frame_windows(spec, 64) |
(ceil(frames / 64), 64, bins) |
(2, 64, 257) |
尾端填補,float32 |
kudio.spectrogram_to_waveform(y, spec) |
(len(y),) |
(32000,) |
float32 |
這裡的音框是 STFT 分析窗的一個位置,不是音訊檔案那頁 (frames, channels) 陣列裡的一列。上表的 frames 是 len(y) // 256 + 1,這段片段是 126;mel_frames 是同樣的算法,只是換成 mfcc 和 melspectrogram 的 512 個樣本位移,這裡是 63。melspectrogram 接受 hop_length=,mfcc 不接受。
用一個物件存放 STFT 設定
頻譜圖和從它重建出來的波形,n_fft、hop_length、win_length 和 window 必須一致。如果分別手動傳給兩個函式,只要有人改了其中一個,這四個值就對不上了,所以 STFT 把它們連同當初選定這些值時的取樣率,綁成一個值,也就是這個轉換的幾何設定(geometry)。它的 forward 就是套用這些設定的 waveform_to_spectrogram:
stft = kudio.STFT(sr=16000, n_fft=512, hop_length=256)
print(stft.win_length, stft.window)             # 512 hamming
print(stft.n_bins, stft.n_frames(len(y)))       # 257 126
print(stft.frame_times(3))                      # [0.    0.016 0.032]
spec = stft.forward(y)                          # (126, 257) float32
- 除非另外指定,窗函數是 Hamming 窗,
win_length預設等於n_fft。librosa 的預設是 Hann 窗、n_fft=2048和 512 個樣本的位移,所以用它的預設做出的頻譜圖,和這裡做出的不只數值不同,連形狀都不一樣。 - 轉換是置中的:訊號兩端各補
n_fft // 2個零,第 t 個音框的中心在第t * hop_length個樣本。frame_times以秒為單位回傳這些中心點。 - 轉換只接受單一聲道。
file_load加mono=False得到的(frames, channels)陣列,會以FeatureError拒絕,而不是把每個樣本當成一個很短的音框來讀。請用y.mean(axis=1)混成單聲道,或者每個聲道分開分析。 - 這個物件是凍結的(frozen),所以交給其他元件的幾何設定,不會在對方不知情的情況下被改掉。
forward(context=n)等於waveform_to_spectrogram(forward_backward=n):它在每個音框兩側各堆疊 n 個補零的鄰近音框(前後文與視窗)。
對數功率,以及 norm=True 做了什麼
waveform_to_spectrogram 回傳 log10(|X|**2),也就是以貝爾為單位的功率;乘以 10 就是 dB。沒有能量的頻率格取不了對數,所以會先在複數頻譜上加 np.finfo(float).eps(2.2e-16),數位靜音的頻率格因此是 -31.3。只有數位上的零才會到這個值:16-bit 檔案的捨入雜訊大約在 -8。我保留這個下限,是因為用這些特徵訓練出來的每個模型,都把 -31.3 當成靜音,移動它會讓這些模型的輸入跟著偏移。如果它礙事,請自己設下限,例如 np.maximum(spec, -10)(-100 dB)。
norm=True 會用片段自己的音框,把每個頻率格標準化,所以每個頻率格的平均值都是 0、標準差都是 1。這帶來兩個結果:
- 錄音的準位沒了,整體的頻譜形狀也沒了。把雜訊片段乘以 0.01(-40 dB),結果的變化不到 2e-5。
- 統計量不會回傳,所以
norm=True的頻譜圖無法轉回原本的音訊。如果模型的輸出還要變回聲音,請用Standardizer(見下文)。
梅爾頻譜圖與 MFCC
melspectrogram 回傳的是堆疊起來的對數梅爾向量,不是頻譜圖。第 i 列存放對數梅爾頻譜圖的第 i 到第 i + n_frames - 1 個音框,最早的在前,所以預設值(n_mels=64、n_frames=5)會得到每列 320 個值:五個音框寬的滑動視窗每移一個位置,就是一個向量,也就是音框層級的自編碼器訓練用的輸入。
feats = kudio.melspectrogram(y, sr=sr)               # (59, 320)
mel = kudio.melspectrogram(y, sr=sr, n_frames=1)     # (63, 64), plain log-mel
aligned = kudio.melspectrogram(y, sr=sr, n_frames=1,
                               n_fft=512, hop_length=256)   # (126, 64)
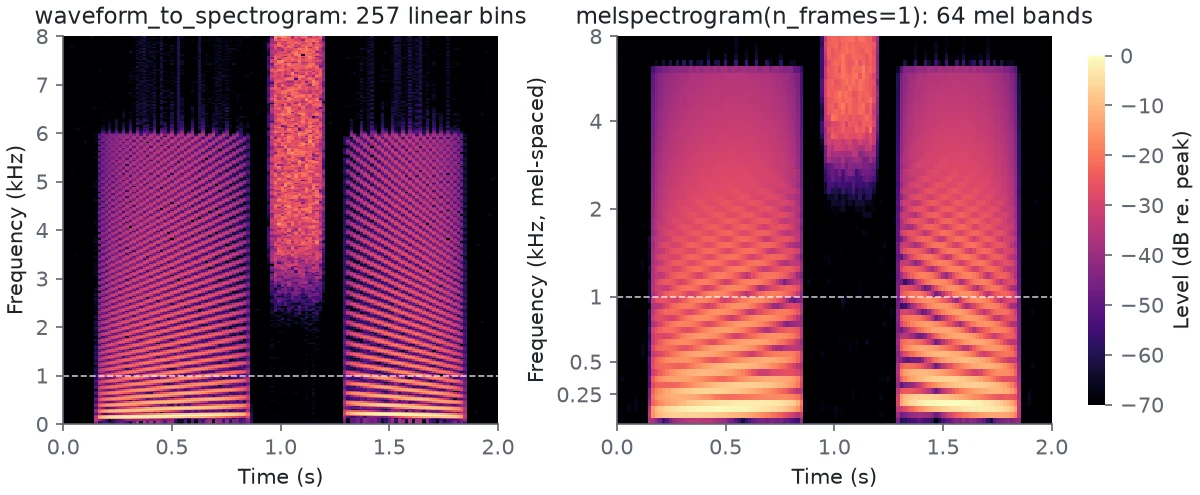
兩個合成的有聲音節,中間夾著一段嘶聲,兩張圖都用 n_fft=512 和 hop_length=256 做出來,各自以自己的峰值為基準。1 kHz 的虛線以下,在線性圖上只佔八分之一,在梅爾圖上卻佔三分之一(64 個頻帶中的 21 個)。虛線以上,梅爾頻帶越來越寬,寬到左圖還分得開的諧波,在這裡併進同一個頻帶。
- 預設
n_frames=5時,第 i 列的中心在第 i + 2 個音框,列數比音框數少四,這裡是 59 對 63。在同樣 512 樣本格點上的逐音框標籤,對應方式是labels[2:2 + len(feats)]。要每個音框一列,就用n_frames=1,再用stack_context加上鄰近音框:kudio.stack_context(mel, 2)是(63, 320),排列方式和feats相同,只是兩端多了填補的列。 source可以是檔案路徑或 NumPy 陣列。路徑會以單聲道載入,有給sr=就用那個取樣率,沒給就用檔案本身的,所以兩秒長的 44.1 kHz 檔案,用sr=16000, n_frames=1會得到 63 列,不給sr=則是 173 列。- 陣列需要以關鍵字傳入
sr=(第二個位置參數是n_mels);沒有的話會引發FeatureError。 - 預設是
n_fft=1024和hop_length=512,不是頻譜圖的 512 和 256。像上面最後一行那樣兩個都傳,才會和STFT一列對一列。窗函數維持 librosa 預設的 Hann 窗;melspectrogram沒有窗函數的參數。 - 短於
n_frames個音框的片段,會得到空的(0, n_mels * n_frames)陣列,不會引發錯誤;frame_windows則會以FeatureError拒絕它。這種片段請在進入訓練集之前就拿掉。 - 結果和頻譜圖一樣是 float32,所以兩者可以直接堆疊,不必轉型。
mfcc 接受陣列和它的取樣率,不接受路徑,回傳 (1, mel_frames, n_mfcc);用 [0] 去掉批次軸。除了 n_mfcc,其他都是 librosa 的預設:Hann 窗、n_fft=2048、512 個樣本的位移和 128 個梅爾頻帶。要在頻譜圖的 256 樣本格點上算 MFCC,請直接呼叫 librosa 再轉置:librosa.feature.mfcc(y=y, sr=sr, n_mfcc=13, n_fft=512, hop_length=256).T 是 (126, 13)。
前後文與視窗
有三個輔助工具會把 (frames, dim) 特徵矩陣(頻譜圖或 mfcc(...)[0] 都可以)轉成模型訓練用的形式,型別是 float32。stack_context 和 frame_windows 接受一個二維矩陣;ContextFrames 接受一串矩陣,三維陣列則當成每段語句一個矩陣來讀。
stack_context
stack_context 把每個音框和它前後各 context 個音框接在一起:(frames, dim) 變成 (frames, dim * (2 * context + 1)),最早的音框在前,音框本身在正中間。兩端是填補而不是丟掉,所以每一列輸入正好對應一列輸出,從第 t 列做出的預測就屬於第 t 個音框。
frames = np.arange(12, dtype=np.float32).reshape(4, 3)
print(kudio.stack_context(frames, context=1))
print(kudio.stack_context(frames, context=1, pad="zero")[0])
[[ 0.  1.  2.  0.  1.  2.  3.  4.  5.]
 [ 0.  1.  2.  3.  4.  5.  6.  7.  8.]
 [ 3.  4.  5.  6.  7.  8.  9. 10. 11.]
 [ 6.  7.  8.  9. 10. 11.  9. 10. 11.]]
[0. 0. 0. 0. 1. 2. 3. 4. 5.]
預設的 pad="edge" 會重複第一個和最後一個音框;pad="zero" 則補零。我把 edge 設成預設,是因為在這些特徵裡,全零的列都不是靜音:在 log10 功率中,0 代表功率為 1(靜音是 -31.3),經過 Standardizer 之後,0 則是一個平均的音框。forward_backward= 和 STFT.forward(context=) 一律補零。要用邊緣填補,請先算不帶前後文的頻譜圖,再對它呼叫 stack_context。
ContextFrames
前後各堆疊 5 個音框,每一列就有十一個音框寬,事先堆疊好的訓練集,會佔用特徵本身十一倍的記憶體。ContextFrames 只存一份特徵,只在你要哪幾列時才堆疊那幾列:
rng = np.random.default_rng(0)
utterances = [rng.standard_normal((n, 257)).astype(np.float32) for n in (300, 120, 410)]

bank = kudio.ContextFrames(utterances, context=5)
print(bank.shape)                                            # (830, 2827)
batch = bank[[0, 5, 829]]                                    # (3, 2827)

full = np.vstack([kudio.stack_context(u, 5) for u in utterances])
kept = sum(u.nbytes for u in utterances) / 2**20
print(f"{kept:.2f} MiB of features, {full.nbytes / 2**20:.2f} MiB stacked")
# 0.81 MiB of features, 8.95 MiB stacked
print(np.array_equal(batch, full[[0, 5, 829]]))              # True
每段語句都在自己的邊緣填補,所以前後文不會跨進下一段語句。bank 的第 i 列就是那個 np.vstack 的第 i 列,所以用 np.vstack(targets) 做出的目標,索引會一一對齊。np.asarray(bank) 會建出完整的堆疊,在真實的語料庫上,這正是你本來想省下的記憶體。
frame_windows
frame_windows 把矩陣切成互不重疊、每個 n_frames 長的視窗:(frames, dim) 變成 (ceil(frames / n_frames), n_frames, dim),也就是序列模型訓練用的形狀。尾端會填補,預設是複製最後一個音框,用 pad="zero" 則補零,所以比一個視窗還短的片段,仍然會得到一個視窗。
windows = kudio.frame_windows(spec, n_frames=64)             # (2, 64, 257)
print(np.array_equal(windows.reshape(-1, 257)[:len(spec)], spec))   # True
126 個音框填進兩個 64 音框的視窗,多出兩個填補用的音框,模型會把它們當成真的音框。請記下 len(spec):損失函數應該跳過這些音框,轉回音訊時也得再把它們切掉(轉回波形)。
用訓練集的統計量標準化
Standardizer 為每個特徵維度(頻譜圖的每個頻率格)存放一個平均值和一個標準差,是用訓練特徵擬合出來的。這兩個陣列和權重一樣,都是訓練好的模型的一部分:給模型尺度不同、或根本沒標準化的輸入,它照樣會給答案,只是答錯。下面的區塊會讀 data/train/ 底下的 WAV 訓練集;手邊沒有的話,用 training_clips = [y] 跟著做。
from pathlib import Path

training_clips = [kudio.file_load(p, sr=stft.sr)[0]
                  for p in sorted(Path("data/train").glob("*.wav"))]
train = np.vstack([stft.forward(c) for c in training_clips])    # (frames, 257)
std = kudio.Standardizer().fit(train)

x = std.transform(windows)            # (2, 64, 257) float32, the model's input
print(np.allclose(std.inverse(x), windows, atol=1e-4))          # True
fit 只接受二維矩陣。請像上面那樣,在切成視窗之前就用音框擬合,這樣尾端的填補就不會算進統計量;transform 和 inverse 可以在任意的前置軸上廣播。和 norm=True 不同,統計量來自訓練集,而且會存下來,所以錄音的準位(相對於訓練資料)會保留,inverse 也能還原縮放。
標準差會加上 1e-8,所以在訓練集裡從不變化的維度不會除以零;但之後這個維度上只要差 0.1,就會變成 1e7。擬合之後請檢查 (std.std < 1e-6).any()。
把幾何設定和統計量一起存起來
to_dict 把 STFT 設定轉成普通的 dict,可以直接存成 JSON;Standardizer.save 則把兩個陣列寫進 .npz,需要時會建立資料夾。兩者都存在檢查點旁邊,載入檢查點時一起載入:
import json

run = Path("runs/exp1")
run.mkdir(parents=True, exist_ok=True)
(run / "stft.json").write_text(json.dumps(stft.to_dict()))
std.save(run / "stats.npz")

# wherever the model is loaded again
stft = kudio.STFT.from_dict(json.loads((run / "stft.json").read_text()))
std = kudio.Standardizer.load(run / "stats.npz")

clip, _ = kudio.file_load("clip.wav", sr=stft.sr)   # any recording, at the model's rate
model_input = std.transform(stft.forward(clip))
save 會回傳它寫入的路徑。名稱沒有 .npz 時,numpy 會自動加上,所以 std.save(run / "stats") 寫入並回傳 stats.npz,Standardizer.load(run / "stats") 也找得到它。from_dict 遇到不認得的鍵(打錯字時是 ValueError: unknown STFT key(s): n_ftt)或缺少的鍵都會拒絕,而不是填一個模型訓練時沒用過的預設值,所以請用 to_dict() 寫這個檔案,不要手寫。
轉換從不重新取樣。對於以陣列形式、帶著自己的取樣率進來的音訊,例如一段錄音,matches 會告訴你是否要先 resample。
轉回波形
用標準化視窗訓練的模型,預測出來的也是標準化視窗。Standardizer.inverse 搭配縮放目標時用的那組統計量,把預測轉回 log10 功率,再由 STFT.inverse 或 spectrogram_to_waveform 轉成音訊。對數功率頻譜圖沒有相位,所以兩者都從一個參考波形取得相位,通常就是模型剛清理過的那段含雜訊輸入(這種配對來自建立含雜訊資料集):
# x stands in for the model's prediction: standardised, in windows
cleaned = std.inverse(x).reshape(-1, stft.n_bins)[:len(spec)]   # (126, 257)
cleaned[:, stft.n_bins // 2:] -= 2.0  # bins from 4 kHz up, 20 dB down
out = stft.inverse(y, cleaned)        # magnitude from cleaned, phase from y
print(out.shape, out.dtype)           # (32000,) float32

change = stft.forward(out) - stft.forward(y)
print(round(float(change[:, stft.n_bins // 2:].mean()), 3))   # -1.987, in bels
- 這些列必須是同一套幾何設定算出的單純 log10 功率,參考訊號的每個音框一列。
norm=True的頻譜圖照樣能跑,不會引發錯誤,但回來的準位不對,頻譜也被壓平了。堆疊了前後文的列,或還帶著尾端填補的視窗,會引發FeatureError,訊息裡會列出兩邊的形狀,所以上面的區塊才會把視窗攤平,再切回len(spec)列。 - 輸出剛好是
len(y)個樣本,每一個都是從頻譜圖重建的,最後不滿一個位移的那一小段也一樣。原封不動來回轉換一次,誤差最多 6e-8,這段片段如此,只取它的第一秒、結尾停在一個位移中間時也是如此。
save_spectrogram_as_wave 從檔案做同樣的事:kudio.save_spectrogram_as_wave("enhanced.wav", "noisy.wav", cleaned) 以 noisy.wav 本身的取樣率從它取得相位,寫成 16-bit PCM,超過滿刻度的部分會削掉,而不是繞回去。它把幾何設定當成個別的參數來接,預設值和預設的 STFT 相同;其他幾何設定請呼叫 stft.inverse,再用 save_wave 寫出。
需要相位本身時,例如套用複數遮罩,或在複數頻譜上乘增益,請用 analyse 和 synthesise。降噪那頁的頻譜方法就是用這一對,只是有自己的音框設定:Hann 窗和 n_fft // 4 的位移。
X = stft.analyse(y)                   # (126, 257) complex64
gain = np.ones(stft.n_bins, np.float32)
gain[stft.n_bins // 2:] = 0.1         # the same 20 dB, on the complex spectrum
out = stft.synthesise(X * gain, length=len(y))

# a log-power spectrogram with the phase of y, every sample rebuilt
out = stft.synthesise(np.sqrt(10.0 ** cleaned) * np.exp(1j * np.angle(X)),
                      length=len(y))
請傳 length=len(y)。不傳的話,synthesise 會停在最後一個完整的位移,一秒長的片段就是第 15872 個樣本。
一次處理很多檔案
file_to_spectrogram 以單聲道載入檔案,回傳和 waveform_to_spectrogram 相同的結果,除非 window= 指定別的,否則用 Hamming 窗。另外兩個輔助工具會對一串檔案逐一處理,再把結果堆疊起來:
files = sorted(Path("data/clean").glob("*.wav"))   # three 16 kHz files: 2.0, 1.5 and 1.0 s

rows = kudio.logspec_from_files(files, sequence=False, forward_backward=0,
                                norm=False)                          # (283, 257)
seqs = kudio.logspec_from_files(files, sequence=True, forward_backward=0,
                                norm=False, desired_samples=sr)      # (3, 63, 257)
coeffs = kudio.mfcc_from_files(files, n_mfcc=13, desired_samples=sr)    # (3, 32, 13)
- 三維的結果,不論是
logspec_from_files加sequence=True,還是mfcc_from_files,都需要每個檔案產生相同數量的音框,否則 numpy 的vstack會引發ValueError。desired_samples會把每個檔案裁到那麼多個樣本,但只有在沒有檔案比它短時,才能讓長度一致。 - 在
mfcc_from_files裡,desired_length是整數的秒數;在waveform_to_spectrogram和file_to_spectrogram裡則是樣本數。 - 每個檔案都以自己的取樣率讀取,所以在混了 8 和 16 kHz 的資料夾裡,音框和頻率格在每個檔案代表的意義都不一樣。請先轉換整個資料夾(音訊檔案)。
參數在哪裡
STFT 和特徵相關的函式與類別,連同簽名和預設值,都在 API 參考的 STFT 與特徵。還在呼叫 w2s 或 wav2mel 的程式碼,請看從 v2 遷移。